任务的成本,与重试的成本
你不是出门买几百万 token。你是要做一个功能、完成一次迁移,或跑一项任务。token 数是模型到达那里所需的量。
两个每 token 成本相同的模型,在同一任务上可能花差很多。一个读一遍代码。另一个读、试修复、再读。每一步是一轮,每轮重发至此的对话。因此需要更多轮次的模型更贵,即使单价相同。
读完本文,你应能回答关于自己工作的三个问题:
- 我的典型任务在 Opus 5.5 上要花多少?
- 哪些设置会改这个,改多少?
- 怎么查自己的会话用量?
想先说清的权衡是:每种少花 token 的方式,也可能让你丢掉一次做完的任务。更低 effort、更小模型或更少上下文确实能省 token。一次重试往往比那些节省更贵。本文试图给每种权衡标价。
这里有些数字是标价,有些是据此做的示意。图示可交互,读时可改输入。这些是尽力示意,请对照文档与自己的计算。
一项任务要花多少?
Claude Code 里的任务是一个循环。模型读对话、调工具、读结果,再绕一圈直到做完。循环每走一圈是一次请求。四件事决定循环成本。
轮次。 每轮重发至此的对话。更少轮次意味着处理更少输入。
缓存读取。 一轮重发的大多是模型上一轮见过的文本。按缓存读取计费,是输入价的一小部分。
输出 token 类型。 最贵的 token,输入价的五倍。Thinking 按输出计费,因此通往答案路上想得更少的模型更便宜。
模型。 每个模型有自己的价格,列在定价页,因此你选的模型定下每个 token 的价格。
示例用 Opus 5.5 API 标价:每百万输入 token $4、输出 $20、缓存读取 $0.20。与下文计算器一样,示例把缓存输入按读取价计、其余按输入价,并略去缓存写入。token 数为示意。
轮次
假设任务以 20K token 上下文起步,随模型读文件与工具结果长到 120K。40 轮时,平均每轮发约 70K token。任务合计约 2.8M 输入 token,尽管对话从未超过 120K。若 90% 来自缓存,输入约 $1.62。同一任务 25 轮处理约 1.75M token,输入约 $1.02。
一轮的成本高于它新增的 token,因为它重发之前的一切。因此最便宜的一轮,是你不需要的那一轮。
能砍轮次的一个习惯是给模型 检查自己工作的方式。例如可跑的测试、构建,或调用端点的脚本。能自检的模型更早发现错误。
一次过收集所需、并批量工具调用的模型,也更少付重发费。
缓存读取
同样 2.8M 输入 token,若无缓存则 $11.20。命中率 90% 时约 $1.62,96% 时约 $0.99。没有其他设置对输入成本影响这么大。稳定会话会自己保持高命中率。后文会讲一些要避免的、会打穿缓存的操作。
输出 token
在 Opus 5.5 上,一个输出 token 是一次缓存读取的 100 倍。典型任务的 60K 输出 token 花 $1.20,等于从缓存读 6M token。输出含 thinking。你为全部付费,即使 Claude Code 只给你看摘要。因此主要改变模型想多少的 effort,会大幅拉动账单。
模型
缓存读取更便宜的模型主要帮长会话。输出更便宜的主要帮需要大量推理的任务。
Opus 5.5 变了什么
两件事变了:价格,以及模型做多少活。
每条价格线都更低。 输入与输出 token 比 Opus 5 便宜 20%。缓存读取便宜 60%。输入价下降,读取比例随之从输入价的十分之一降到二十分之一。图 A 按每百万 token 比较两模型。这些是 API 标价。在 Pro、Max 或 Team 计划上,更低的 Opus 5.5 价会传到你的限额(含缓存上下文),因此比 Opus 5 大约多走 25%。缓存读取的额外削减是 API 价格变更。
另外,Pro、Max、Team 与按席位的 Enterprise 计划上,五小时限额提高了;符合条件的订阅者有一个可自选时机使用的限额重置。在网页或 Claude Desktop 的 Settings > Usage 下找,不在终端里的 Claude Code。重置作用于整个账户,含 Claude Code。
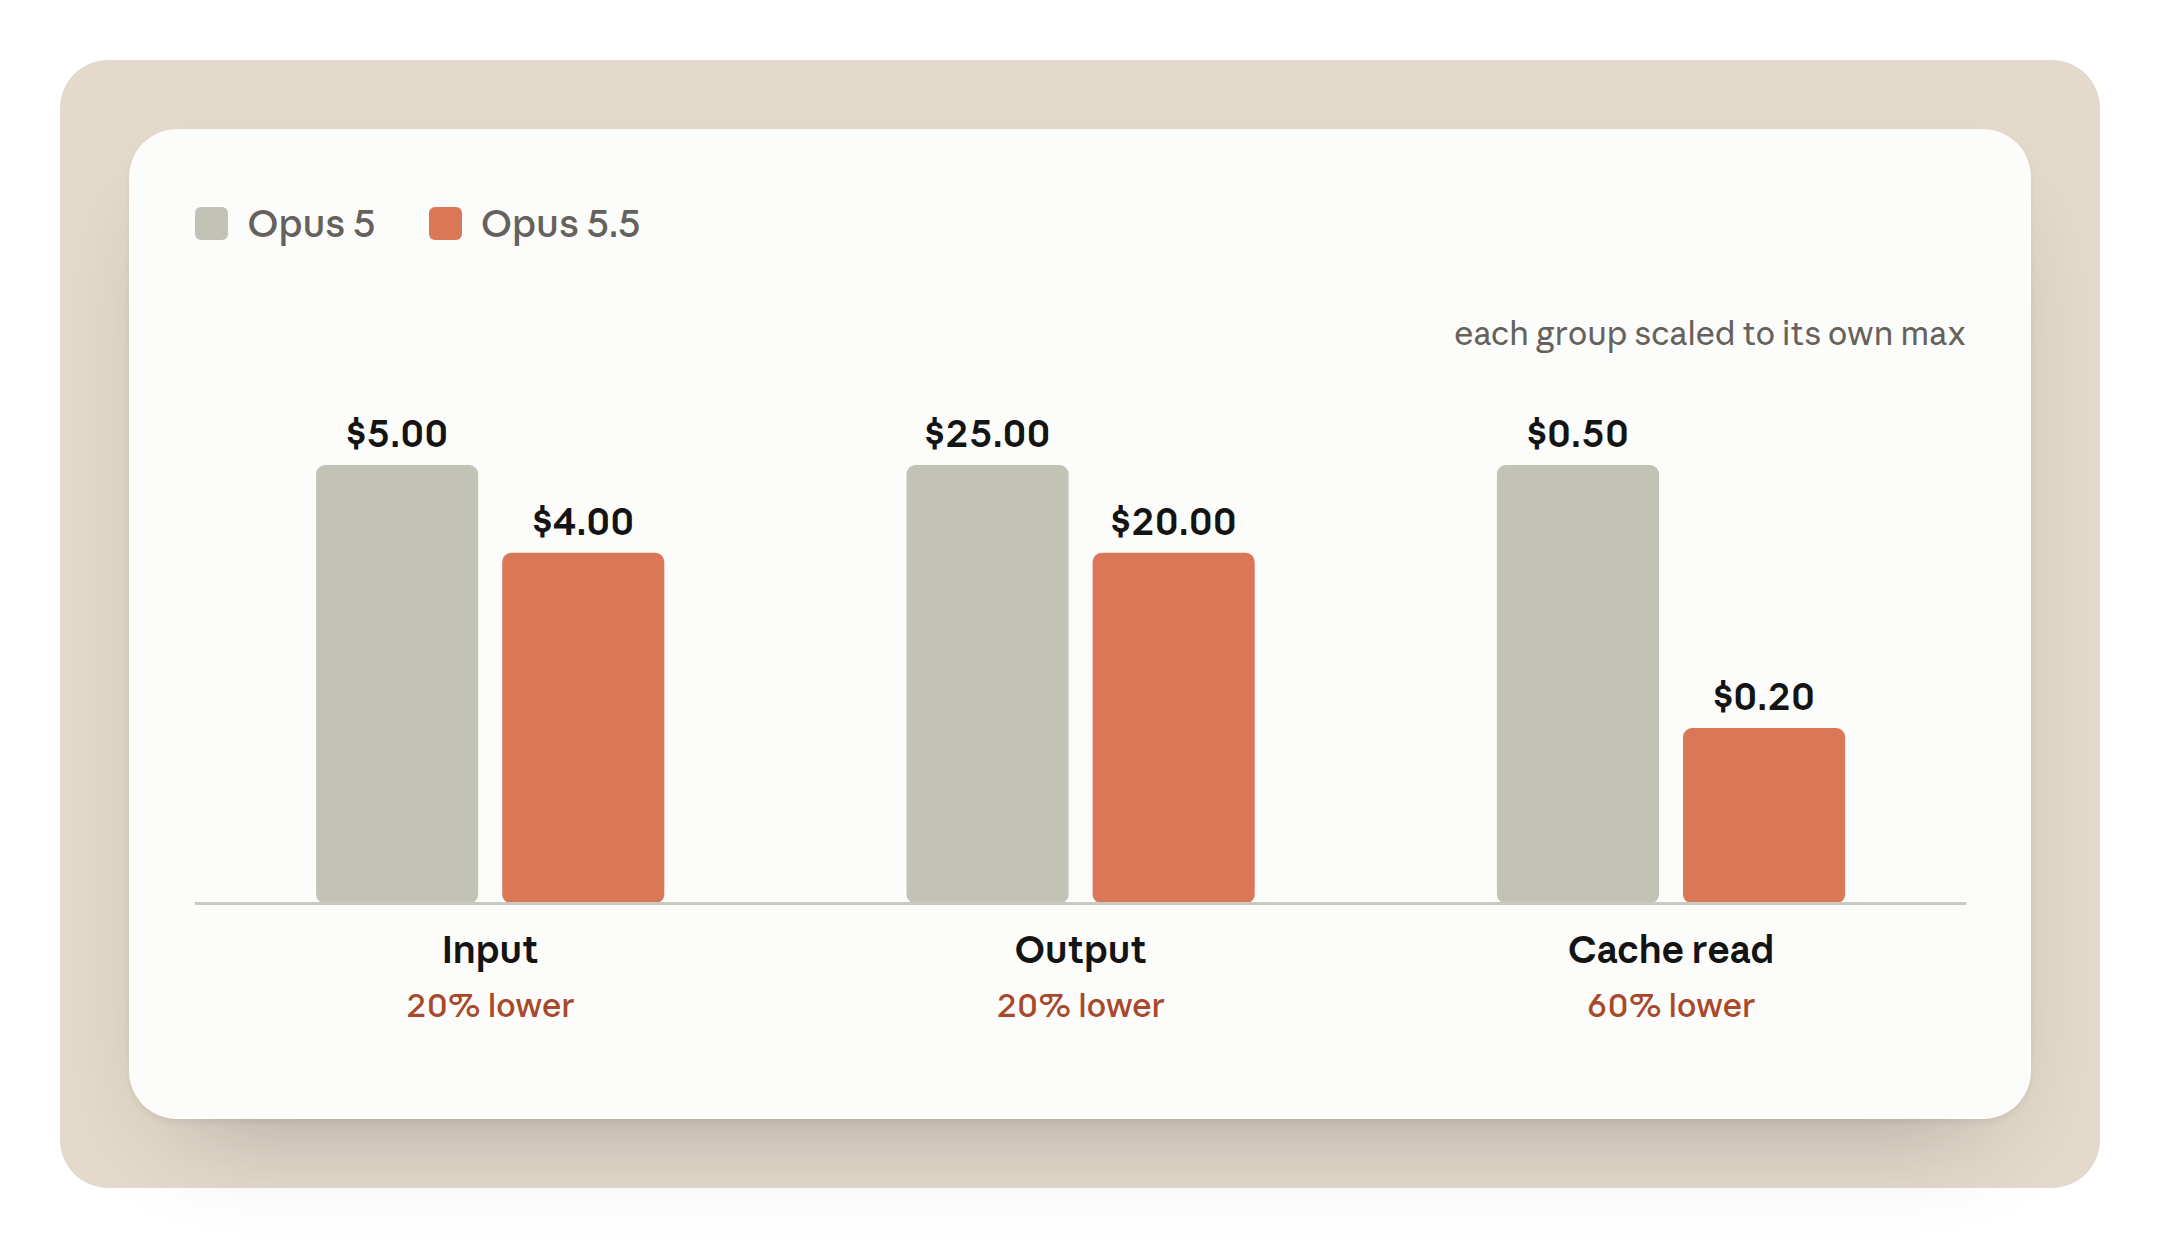
每百万 token 的 API 标价。
在 API key 上,缓存读取降价对 Claude Code 最要紧。长 agentic 会话的输入大多花在缓存读取上。图 B 定价的会话里,缓存一行从 $1.00 到 $0.40,是收据上最大降幅。
省多少取决于工作形状。大多是缓存读取的会话,输入最多可省 60%。无缓存、答案很长的短问题最多约省 20%,因为输出占主导。多数 Claude Code 任务介于两者之间。下文计算器显示你的落在哪。
你可能见过 Opus 5.5 跑起来比 Opus 5 便宜 40%。那是我们对按 token 计费、默认设置下典型负载的估计。它假定 Opus 5.5 在 medium 默认下每任务用更少 token,再叠上更低单价,因此不是每个 token 降价 40%。token 价是图 A 那些,图 B 单独展示价格变更的效果。
Opus 5.5 可能在一次回答上用更多 token,因为它总在回复前思考。我们预期人们在 Opus 5.5 上能做更多,但因任务而异,请在自己的工作上度量。图 C 比较两模型每任务成本。这部分比价格更依赖你的工作。
规格清楚的任务上,两模型大约同样轮次做完,你只拿到降价。差距应在开放任务上最大——模型可能在错误想法上花很多轮。没有一个数字对每个代码库成立,因此要度量(见最后一节)。
长跑以报告结束。 Opus 5.5 结束长跑时说明改了什么、发现了什么、需要你做什么。这也能省钱,因为你能看见发生了什么时,更少重跑会话。
同一批任务并排比较
图 B 用相同 token 数给两模型的同一会话定价。因此差别只有价格变更。切换模型比较。token 数为示意。
交互图:同一示意会话用相同 token 在两模型上定价,差别只有价格变更。 见原文页:https://claude.dev/blog/what-a-task-costs-on-opus-5-5/
收据有 /usage 对会话显示的三行。缓存读取按 token 最大,2M。输出按 token 最小、按成本最大。新鲜输入居中:覆盖每个文件的首次读取与每个新工具结果。
图 B 给两模型相同 token 数,因此只展示价格变更。你自己的会话在 Opus 5.5 上可能用更多或更少 token。那样定价时,会话大约便宜 31%。
录制运行加上第二层效果:模型做多少活的变化。有假起步的任务上,差距应拉大。
试你自己的数字
填入你某项任务的用量,或从预设起步。预设相当示意,仍建议自己算。缓存输入按缓存读取价、新鲜输入按输入价,因此缓存滑块显示差距多少来自缓存读取。
要从真实会话填滑块,任务结束时跑 /usage。Session 块给出输入、输出与缓存数字。最后一个滑块是你对 Opus 5.5 在任务上少做多少活的假设。留 0% 则只看价格变更。要从自己的工作设它:在 Opus 5 与 Opus 5.5 上跑同一任务,比较轮次与输出 token。「自己度量」会走一遍,「读一次会话」说明在 /usage 里查什么。
交互图:一项任务的 token 在两模型上定价,一次运行与一个月运行,来自滑块与预设。 见原文页:https://claude.dev/blog/what-a-task-costs-on-opus-5-5/
最大化会话价值的技巧
Opus 5.5 更低的价格让每个 token 更便宜。你怎么跑会话决定用多少 token,下面这些步骤有帮助。
先提高 effort,再换模型
Effort 给模型每轮花多少 token 设大致倾向:思考、写出的文本、工具调用。更低 effort 时工具调用更少、更短。Opus 5.5 有四档(low、medium、high、xhigh),外加单会话的 max。选一档看何时用、以及设置命令。
交互图:effort 档位、何时用各档,以及设置命令。 见原文页:https://claude.dev/blog/what-a-task-costs-on-opus-5-5/
Claude Code 为每个模型设默认档,/effort status 显示你的。规格清楚的日常工作试 medium。medium 卡住时试 high。它每轮比 medium 花更多,但比换更大模型少。机械工作用 low,如重命名或跨文件套用已知模式。
Opus 5.5 默认是 medium,比 Opus 5 默认的 high 低一档。各档在不同模型上不代表同样的思考量。给定档位上,Opus 5.5 每轮比 Opus 5 想得更多,尤其在 xhigh 与 max。因此不要沿用为 Opus 5 选的档。从 medium 起,把 xhigh 与 max 留给你已度量有增益的工作。
粗略想 effort 定价:假设 high 在一项任务上多加 20K thinking token。在 Opus 5.5 上是 $0.40。十轮重试循环、每轮 100K 缓存上下文、合计 10K 输出 token,成本大约相同。因此 high 在能省一次重试的任务上能回本。在 medium 第一次就会做完的任务上,是浪费。
medium 只修一层时
最需要更多 effort 的清晰信号,是修复停在一层。
比如 API handler 里字段改名。medium 下模型更新 handler、handler 测试通过,客户端仍发旧字段。它做了要求的事,只是没读够远找到第二个调用者。high 下它在写之前花更多轮读调用点,并一次改两层。
检查也能抓住同一 bug。若模型能跑穿过客户端的测试,旧字段在写出那一轮就会在 medium 上失败。因此抬高 effort 前,先看模型有没有检查工作的方式。跑测试花一轮及其输出。更多 effort 给每一轮加思考。
若抬 effort 与加检查都不行,再换更大模型。
会话中途改 effort
在 Claude Code 里跑 /effort 加档位,例如 /effort high。/effort status 打印当前档。可在任务中途改,新档用于下一次请求。
在 Opus 5.5 上用 API key 或 Claude 订阅时,改 effort 保留缓存。可为一步难的抬高再降回,无需重写对话。在 Amazon Bedrock、Google Cloud 的 Agent Platform 或 Claude apps gateway 上,改 effort 仍会清掉已缓存对话,下一请求对全部付缓存写入价。Opus 5.5 的 thinking 始终开着,没有可改的 thinking 设置。
为工作选对模型
模型选择定下会话里每个 token 的价格,因此比 effort 更能拉动账单。影响也更远:每个继承主模型的 subagent 也继承其价格。多数日子需要三个模型:小的做查找,Opus 5.5 做你密切监督的工作,更大的做最难任务。
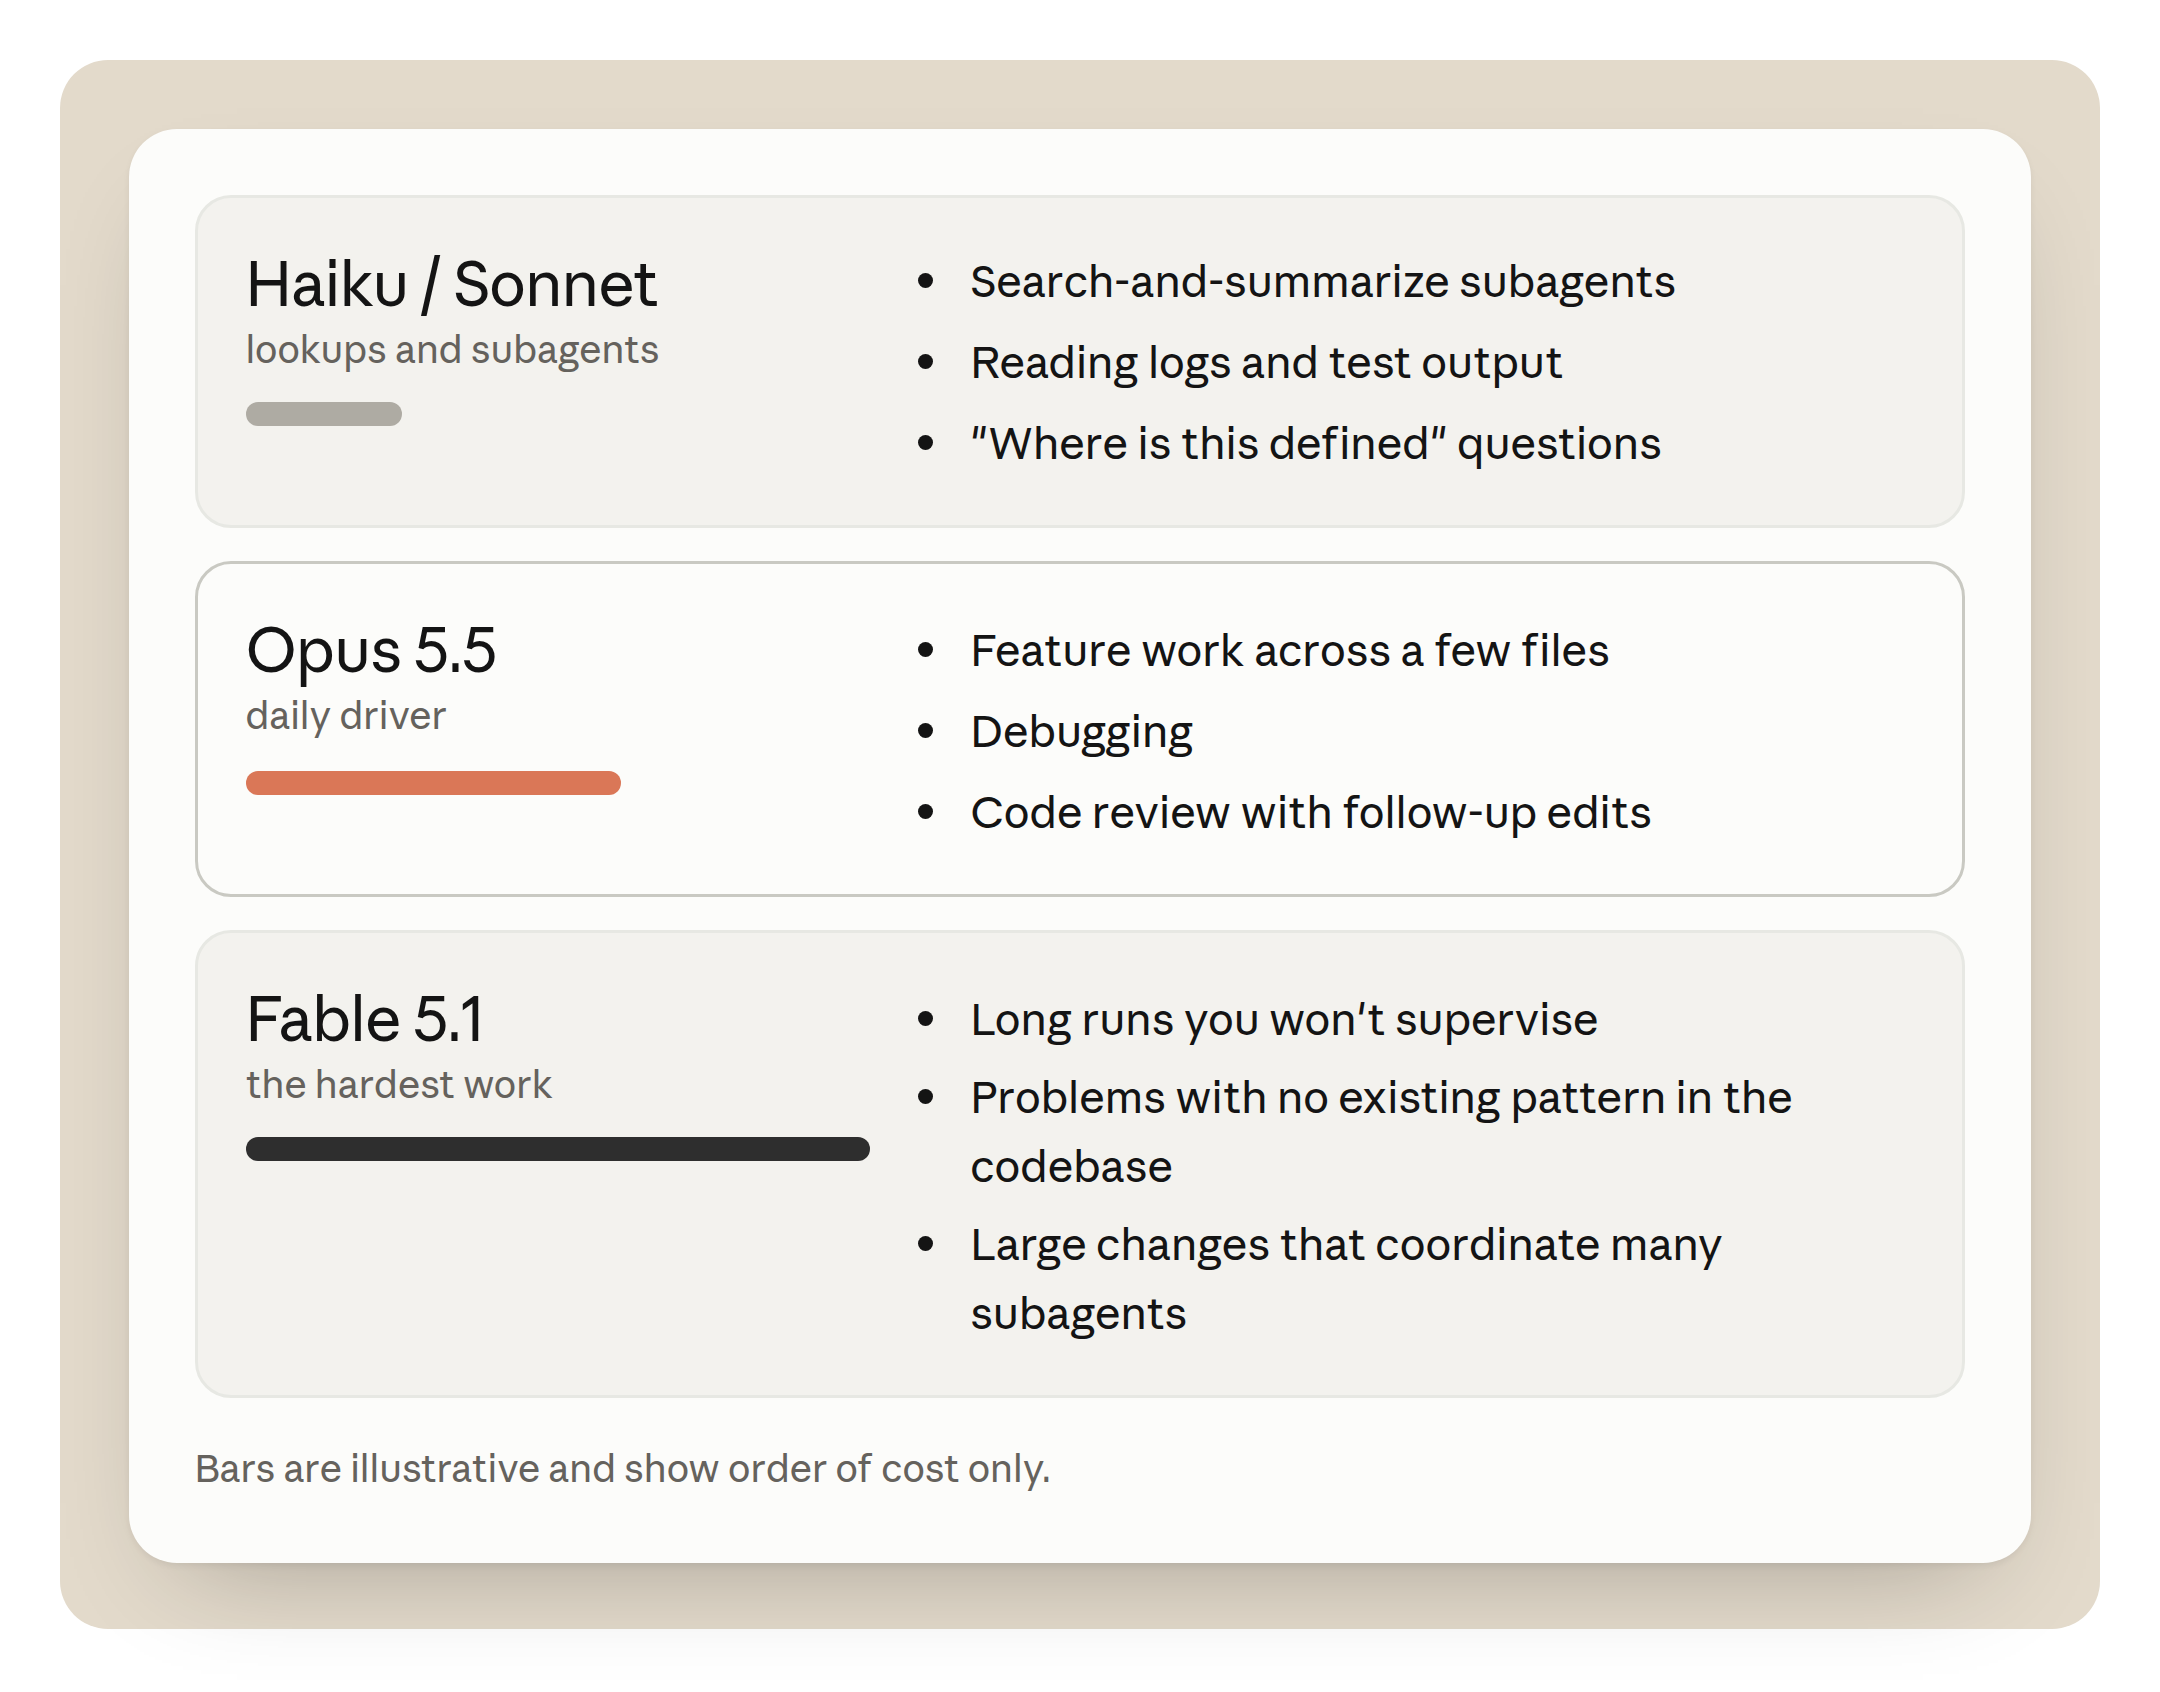
Opus 5.5 作日常主力
用 Opus 5.5 做你监督的工作:跨几个文件的功能、调试,以及带后续编辑的代码审查。你读它做的、漂移时介入,因此循环保持短。
升到 Fable 5.1
结果比 token 价更重要时升到 Fable 5.1。 例如你不会监督的长跑、代码库里没有现成模式的问题,以及协调许多 subagent 的大改动。不要等第三次失败。若 Opus 5.5 在 xhigh 上两次撞同一问题,切换,解决后再切回。交互工作上 Opus 5.5 更合适:延迟更低、更便宜。
Fable 5.1 标价每百万输入 $10、输出 $50,是 Opus 5.5 的两倍半。缓存读取每百万 $0.25,仅 Opus 5.5 的 1.25 倍,因为按输入价的 0.025 倍计。因此差距在长、缓存重的运行上最小,在写很多的任务上最大。
在自然断点切换。缓存属于前一模型,因此预期新模型第一轮对整段对话付写入价。先跑 /compact,或带着短书面计划开新会话,让那一轮更小。用 /model 加别名或模型名切换。/model 也会把选择存成新会话默认,难的部分做完后切回。
查找时降档
查找时降到 Sonnet 或 Haiku,不要用来写代码: 搜索并摘要的 subagent、读日志与测试输出,以及「这定义在哪」类问题。跨很多文件的机械编辑,留在 Opus 5.5 并把 effort 设为 low。编辑留在写其余代码的同一模型上,每轮更便宜。
要把 subagent 放到更小模型,在其定义里设 model: haiku 或 model: sonnet。要把每个 subagent 放到同一模型,设环境变量 CLAUDE_CODE_SUBAGENT_MODEL。subagent 定义里的模型覆盖该变量。无模型设置的 subagent 跑在你的主模型上,除非设了变量。
每个 subagent 在自己的上下文窗口里跑并交回摘要,因此其文件读取不进你的主对话。它仍为自己的 token 付费,因此模型设置决定那笔花费。
Agent teams(实验功能)会放大这一点。每个队友是独立 Claude Code 实例、有自己的上下文窗口,并持续用 token 直到退出。我们的 成本文档 称队友在 plan mode 时,团队大约是标准会话的七倍 token。保持团队小、每项任务自洽,并在其部分做完时关掉队友。
权衡:小模型误读搜索结果会把主模型引向错误文件,主模型为绕路付费。把小模型留在错误便宜可发现的工作上,如找文件、跑测试、读日志。
判断类决定留在主模型。opusplan 别名用另一种拆法:Opus 在 plan mode 规划,Sonnet 执行计划。这把代码编辑放在 Sonnet 上,与上面建议相反。在自己的任务上度量后再当默认。
迁移时检查提示词
为更旧模型写的指令可能让 Opus 5.5 写更多、重复工具调用。在 Claude Code 里跑 /claude-api prompt-audit,检查你的 Claude Code 设置(如 Skills 与 CLAUDE.md)是否有这些 提示词反模式。它也会检查你在 Claude Platform 上构建的应用代码。
我们在从 Opus 4.8 迁到 Opus 5.5 上测过,用的是内部客服基准 44 张 ticket,其提示词带若干这类模式。迁到 Opus 5.5、low effort,基准成本约降 18%。再跑 prompt-audit 又降约 9%,相对 Opus 4.8 起点约低 25%。审计去掉让模型写更多、重复工具调用的仪式指令:强制六步流程、scratchpad 规则、verify-twice 规则,以及互相矛盾的说明。
该结果来自一份基准,当作例子而非预期数字。跑审计,再在真实任务上前后比较 /usage(见「自己度量」)。
缓存与压缩
Claude Code 替你处理缓存与压缩。你怎么跑会话决定它们省多少。
缓存如何工作
Claude Code 缓存请求中重复的部分,如系统提示词、工具定义,以及至此的对话。
在 Opus 5.5 上,缓存读取是新鲜输入 token 的 5%。写入缓存比新鲜读取贵:按今日定价,五分钟缓存为输入价的 1.25 倍,一小时缓存为两倍。每次命中免费重置寿命。
在 Claude Code 里,寿命取决于你怎么付费。Claude 订阅上一小时。API key 或云提供商上默认五分钟;订阅一旦动用用量额度也降到五分钟。
在 120K token 上下文,Opus 5.5 上五分钟写入约 $0.60,读取约 $0.02。一次写入等于约 25 次读取。在 API key 上,六分钟喝咖啡会把下一次 $0.02 读取变成 $0.60 写入。同样大小的一小时写入约 $0.96;在 API 上你可付这笔溢价覆盖白天的空隙。
会话形状与命中率
缓存存前缀,因此只能复用请求从开头起与前一次匹配的部分。
稳定会话每轮在对话末尾追加,并保持高命中率。任何改请求更早部分的操作都会拉低。改工具定义清掉整段缓存;改系统提示词从那一点起清掉——几乎是一切。
实践中,预期在这些时候发生缓存写入:
- 暂停超过缓存寿命;
- 在 Amazon Bedrock、Google Cloud Agent Platform 或 gateway 上改 effort(档位是缓存匹配的一部分);
- 在对话里第一次打开 fast mode(改缓存匹配的一部分);
- 连接或断开 MCP 服务器(可能改每次请求开头加载的内容);
- 换模型(新模型从空缓存起步);以及
- 对话被压缩(重写缓存匹配的历史)。
因此在会话开始时设好这些,工作期间别动。
为何长会话每轮更贵
每轮重发全部上下文,因此即使缓存热着,上下文变长时每轮也更贵。20K token 上下文时,Opus 5.5 上一轮缓存读取约 $0.004。150K 时约 $0.03,那种大小 30 轮仅读取就花 $0.90。同样 30 轮在 20K 约 $0.12。Claude 4.6 及之后更大上下文窗口不改每 token 价,成本完全来自重发对话。
那些上下文很多来自更早工作:一小时前的堆栈、你已用完的文件、你已修过的测试输出。每轮仍全部发送。
压缩、/compact 与 /clear
会话接近上下文上限时,Claude Code 摘要更早历史,让后续轮次发送更少。用 /autocompact 加 token 数可改在多满时触发。
两条命令让你自己做。/clear 清空对话且无成本,换到无关工作时用。/compact 保持连续性,成本是一次请求。它读要摘要的对话,你可说明保留什么,例如 /compact keep the failing test names and the schema change。
在 150K token 压缩的粗略价格约 $0.25:读取、几千输出 token 的摘要,以及更短上下文上的新缓存写入。之后每轮约省 $0.025 读取,因此约十轮回本。快结束前压缩比它省的更贵。
该价格假定缓存热着。缓存热时,摘要请求从缓存读对话,因此在休息前压缩,不要休息后。休息超过缓存寿命后,同一次 /compact 会再读整段对话并写回缓存。在五分钟缓存上 150K token,仅输入约 $0.75。若走了一条想丢掉的路,改用 /rewind 到更早一轮。缓存热时,那回到已缓存的前缀。
摘要也会丢细节。调试中途压缩可能丢掉那一行关键日志。在自然断点压缩;下一步依赖具体东西时,写进 /compact 说明。
你打字前加载什么
你的 CLAUDE.md 在每次会话开始加载进上下文,因此其中每一行都是每轮重发的一部分。成本文档 建议保持在 200 行以下。MCP 工具定义是推迟的:开头只加载工具名与服务器说明,用到工具时才加载完整定义。跑 /mcp 看连了哪些服务器,关掉不用的。
账单其余部分
下表列出影响 Claude Code 会话的其他计费规则,有文档处附链接。
Fast mode 让 Opus 5.5 最高快 2.5 倍,价格为标准的两倍:每百万输入 $8、输出 $40。在 Claude 订阅上记入用量额度,不记入计划限额。打开后第一次请求对整段对话按 fast-mode 输入价付费、无缓存。因此在会话开始时打开,不要深入后才开。
| 账单计什么 | 如何工作 |
|---|---|
| 缓存寿命 | Claude Code 里:订阅上一小时;API key 或云提供商上五分钟,或订阅动用用量额度后。每次命中重置寿命。API 提供更高写入价的一小时缓存。成本文档与提示词缓存文档 |
| 缓存写入 | 按今日 API 定价,五分钟缓存为输入价 1.25×,一小时缓存 2×。定价文档 |
| Thinking | 按输出 token 计费,含未返回给你的 thinking。Extended thinking 文档 |
| Effort | 作用于每个输出 token:文本、工具调用与 thinking。Effort 文档 |
| 自动压缩 | 上下文窗口接近上限时跑。/autocompact 加 token 数设阈值。上下文窗口文档 |
| Subagent 与 agent teams | Subagent 在自己的上下文窗口工作并返回摘要。Plan mode 下的 agent teams 约用标准会话的 7× token。上下文窗口与成本文档 |
| Batch API | 经 Message Batches API 发送的请求,输入与输出 token 半价。批处理文档 |
| 今日典型花费 | 平均:企业部署中每活跃日每开发者约 $13。90% 用户每活跃日成本低于 $30。两数字均针对当前模型。公开文档,成本页 |
自己度量
本文数字是示意。你的代码库、提示词与习惯不同,请在自己的任务上度量成本。怎么查:
- 在会话里跑 /usage。 /cost 做同样的事。Session 块显示 token 用量与按标价估计的美元成本。prompt-cache 行显示多少输入来自缓存。在 Pro、Max、Team 或 Enterprise 计划上,同一屏显示计划用量条。美元数字在你机器上按标价算,因此订阅上是工作量指南,不是账单。
- 同一任务跑两次。 Opus 5.5 需要 Claude Code v2.1.280 或更新,先跑
claude update。从积压里挑,不是玩具例。用 /model 在 Opus 5 与 Opus 5.5 间切换。记下每轮次、输出 token 与成本。下结论前做三或四项任务。 - 对团队,用用量与成本报告。 Claude Code Analytics API 给出每用户估计成本。Usage and Cost API 按模型、按缓存与否拆分花费。
- 试 effort 阶梯。 一项难任务先 medium 再 high。一项机械任务用 low。
读一次会话
任务结束时在 /usage 里查三件事。
- 缓存占比。 长会话应高。若低,找长暂停、换模型、中途连 MCP,或在云提供商/gateway 上改 effort。prompt cache 行常点名上次 miss 的可能原因。
- 输出对照输入。 小改动上大量输出通常意味着 effort 对该任务过高,或模型在重试。
- 总输入对照对话大小。 若总输入是对话大小许多倍,会话走了很多轮,值得读对话找循环在哪重复。
作基线,Claude Code 成本文档给出企业部署平均每活跃日每开发者约 $13,90% 用户低于 $30。远高于你自己正常水平的会话值得回顾。
记住
- 规格清楚的日常工作用 medium effort。
- 给模型检查工作的方式,跨文件的改动从 plan mode 起步。
- medium 卡住时抬到 high。API key 或订阅上改动保留缓存。云提供商或 gateway 上在断点改。
- xhigh 两次撞同一问题,切到 Fable 5.1。解决后再切回。
- 搜索与读日志的 subagent 放 Sonnet 或 Haiku。代码编辑留在 Opus 5.5。
- 让长会话持续推进,缓存保持热。
- 无关任务之间用 /clear;断点用 /compact 并注明保留什么。
- 最重要的一条: 在每个模型上跑一项真实任务,比较 /usage 报告。信任你自己的数字。
希望本文有帮助。若你的限额在 Opus 5.5 上不比 Opus 5 走得更远,用 /feedback 告诉我们。
延伸阅读:有效管理成本 · 模型配置 · 在 Claude Code 里选 Claude 模型与 effort · Effort · 提示词缓存 · 最大化 Claude Code 会话价值
感谢 Michael Segner、Kacie Jenkins 与 Molly Vorwerck 审阅。