上周我们在 Claude Code 发布了 动态工作流。Claude 现在能为手头任务当场写出定制 harness。
默认 Claude Code harness 为编码而建,对其它许多任务也有用——因为很多任务本来就像编码任务。但对某些类别,我们曾不得不在 Claude Code 之上自建定制 harness 才能拉满表现,例如 Research、安全分析、agent teams 或 Code Review。
工作流让你能在 Claude Code 之上动态创建 harness,让 Claude 更原生地解决那些问题。也可与他人共享、复用这些工作流。
本文分享我最初的工作流体验与收获,方便你用足它们。请记住最佳实践仍在形成:动态工作流往往更吃 token,更适合复杂、高价值任务。
示例提示词
进入技术细节前,先给几条示例提示词,帮你想工作流能做什么:
「这个测试大约 50 次里失败 1 次。设一个工作流来复现。形成关于竞态的互竞理论,直到只有一个理论扛得住证据再停。」
「用工作流翻我最近 50 个会话,挖我反复做的纠正,把反复出现的写成 CLAUDE.md 规则。」
「用工作流挖过去六个月 Slack 的 #incidents,找反复出现、却没人开 ticket 的根因。」
「拿我的商业计划跑工作流,让不同 Agent 分别从投资者、客户、竞争对手视角拆解。」
「这有一文件夹 80 份简历,用工作流按后端岗位排序,并复核前十。用 AskUserQuestion 工具采访我做评分标准。」
「要给这个 CLI 工具起名。用工作流头脑风暴一批选项,再跑淘汰赛挑出前 3。」
「用工作流把我们的 User 模型到处改名为 Account。」
「过一遍我的博客草稿,用工作流对照代码库核验每条技术断言,我不想发错东西。」
动态工作流怎么运作
动态工作流执行一个带若干特殊函数的 JavaScript 文件,用于生成与协调 subagent:
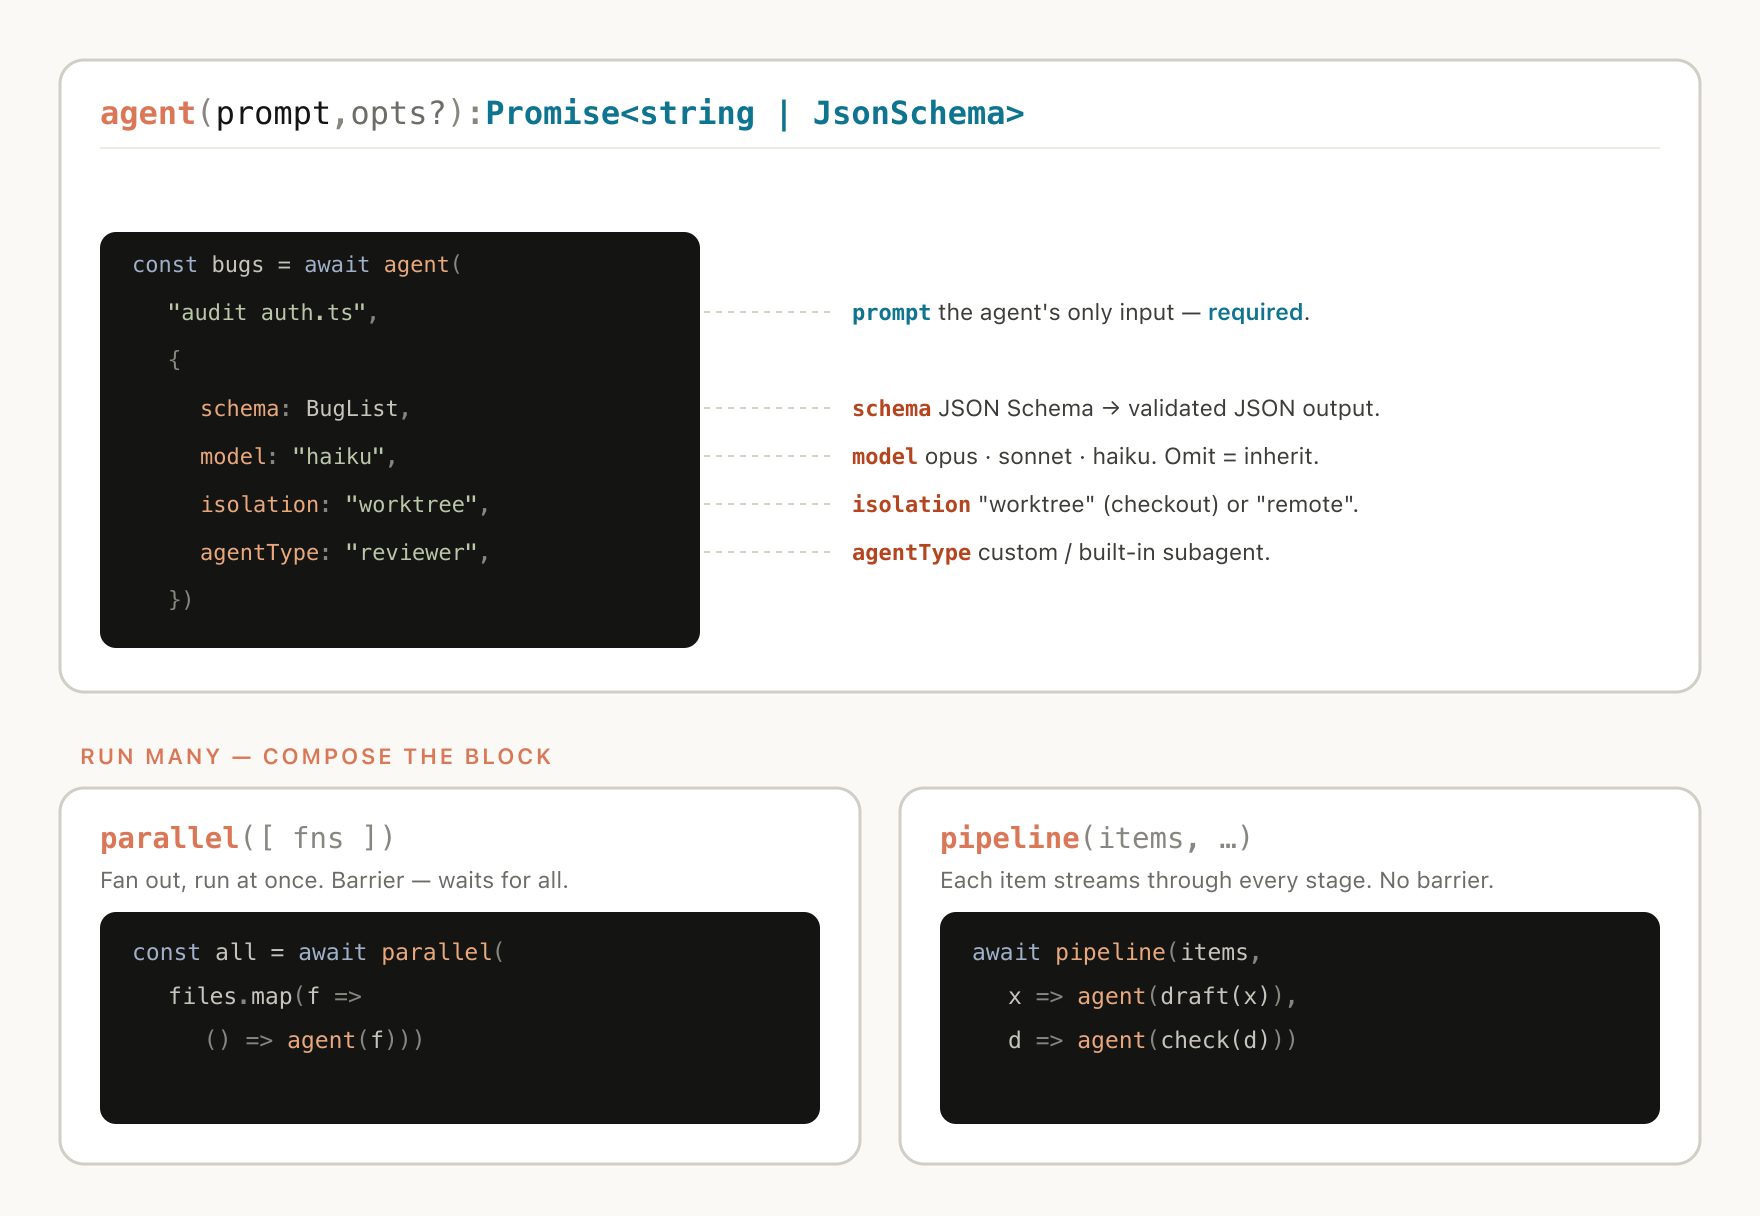
工作流脚本的三块积木:agent() 生成一个 subagent;parallel() 与 pipeline() 组合多个。
动态工作流也含标准 JavaScript 函数如 JSON、Math、Array,便于处理数据。
特别有用的是:动态工作流可决定 Agent 用哪些模型,以及 subagent 是否在自己的 worktree 里跑,让 Claude 选择需要的智力档与隔离度。
若工作流被打断(例如用户操作或退出终端),恢复会话可让工作流从停下处继续。
为何要动态工作流
让默认 Claude Code harness 做事时,它必须在同一上下文窗口里既规划又执行。对许多编码任务这很有效,但在长跑、大规模并行、高度结构化,和/或对抗性任务上会垮。
因为 Claude 在单个上下文窗口里做复杂任务越久,越容易陷入几种失败模式:
- Agentic laziness(Agent 偷懒):Claude 在特别复杂、多段任务未完成前就停,并在部分进展后宣称做完,例如安全审查 50 项里只处理了 35 项。
- Self-preferential bias(自我偏好偏差):Claude 倾向偏好自己的结果或发现,尤其在被要求对照评分标准核验或评判时。
- Goal drift(目标漂移):跨很多轮次逐渐偏离原目标,尤其在压缩之后。每次摘要有损,边界情况要求或「不要做 X」等约束可能丢掉。
创建工作流通过编排各自有独立上下文窗口、目标聚焦隔离的 Claude subagent,来对抗这些问题。
动态 vs 静态工作流
你可能以前用 Claude Agent SDK 或 claude -p 做过静态工作流,协调多个 Claude Code 实例。
但静态工作流要覆盖所有边界情况,通常更通用。有了 Claude Opus 4.8 与动态工作流,Claude 已够聪明,能为你的用例写出定制 harness。
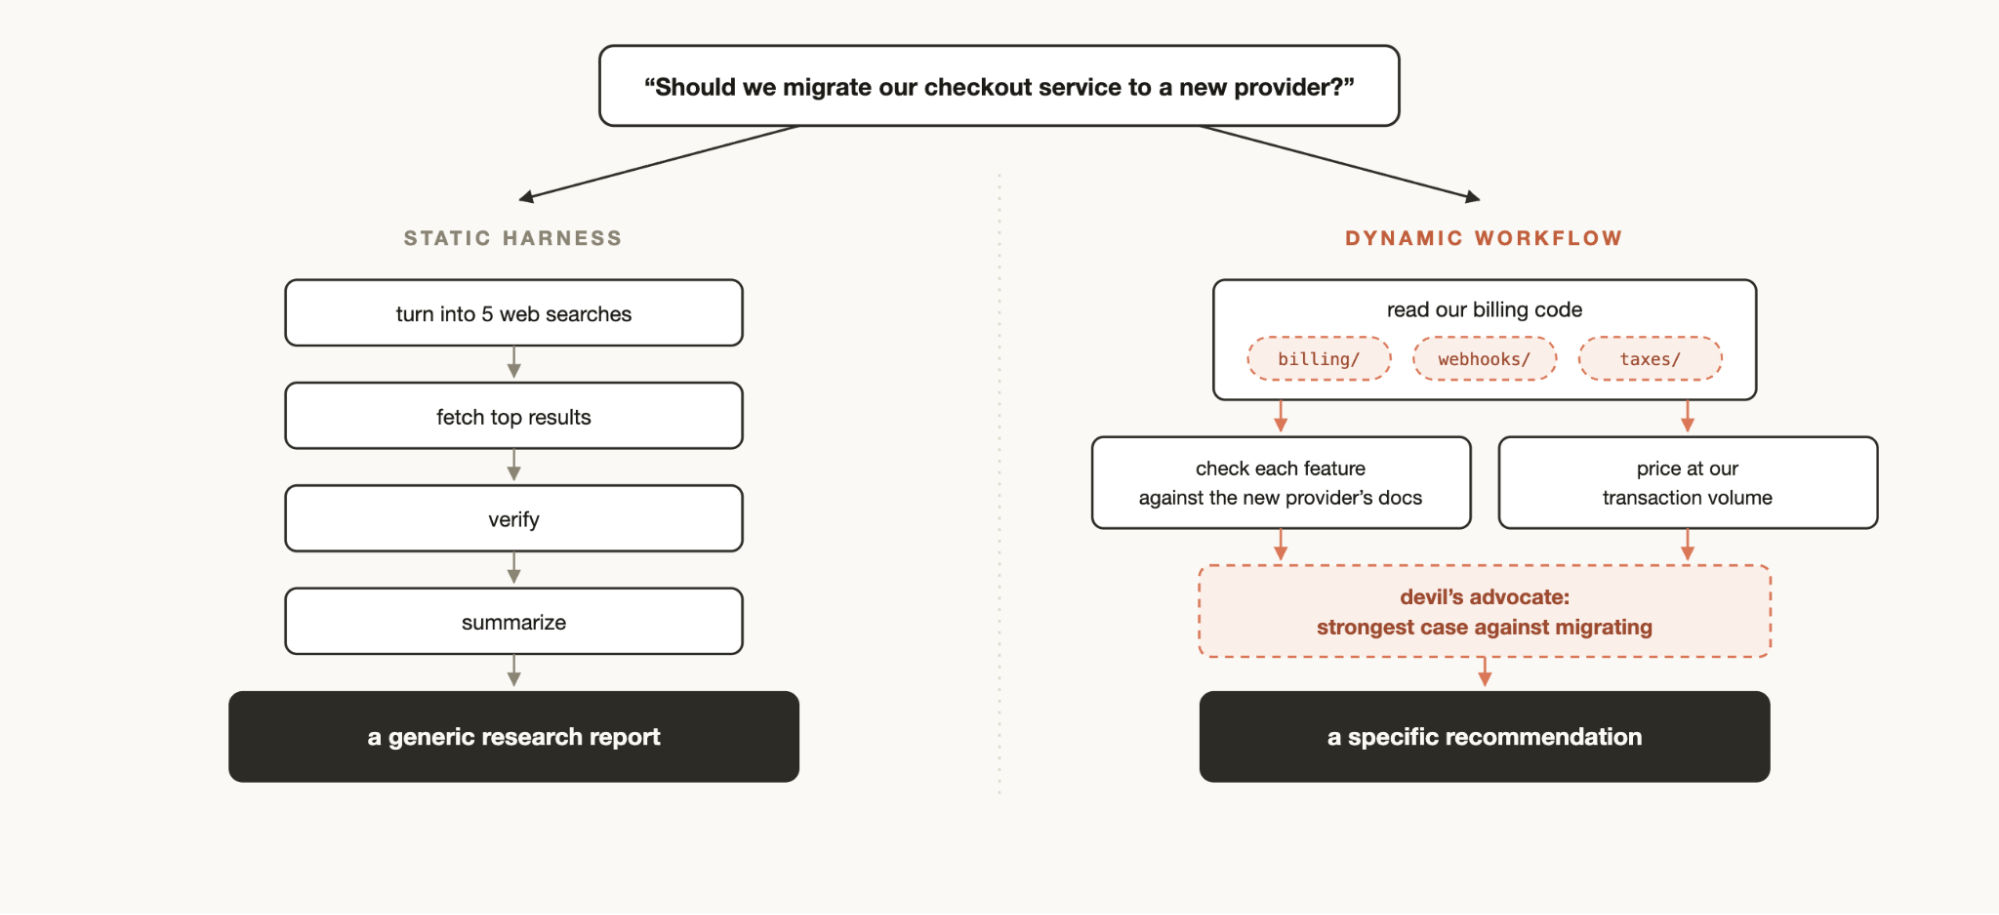
静态 harness 对每个问题跑同一套步骤;动态工作流按眼前问题塑形。
用动态工作流时的有用模式
开始用动态工作流,可以直接让 Claude 做一个,或用触发词「ultracode」确保 Claude Code 创建工作流。
但建立动态工作流如何运作的心智模型,有助于判断何时用、以及如何用提示词轻推 Claude。
Claude 构建工作流时可能用到并组合的几种常见模式:
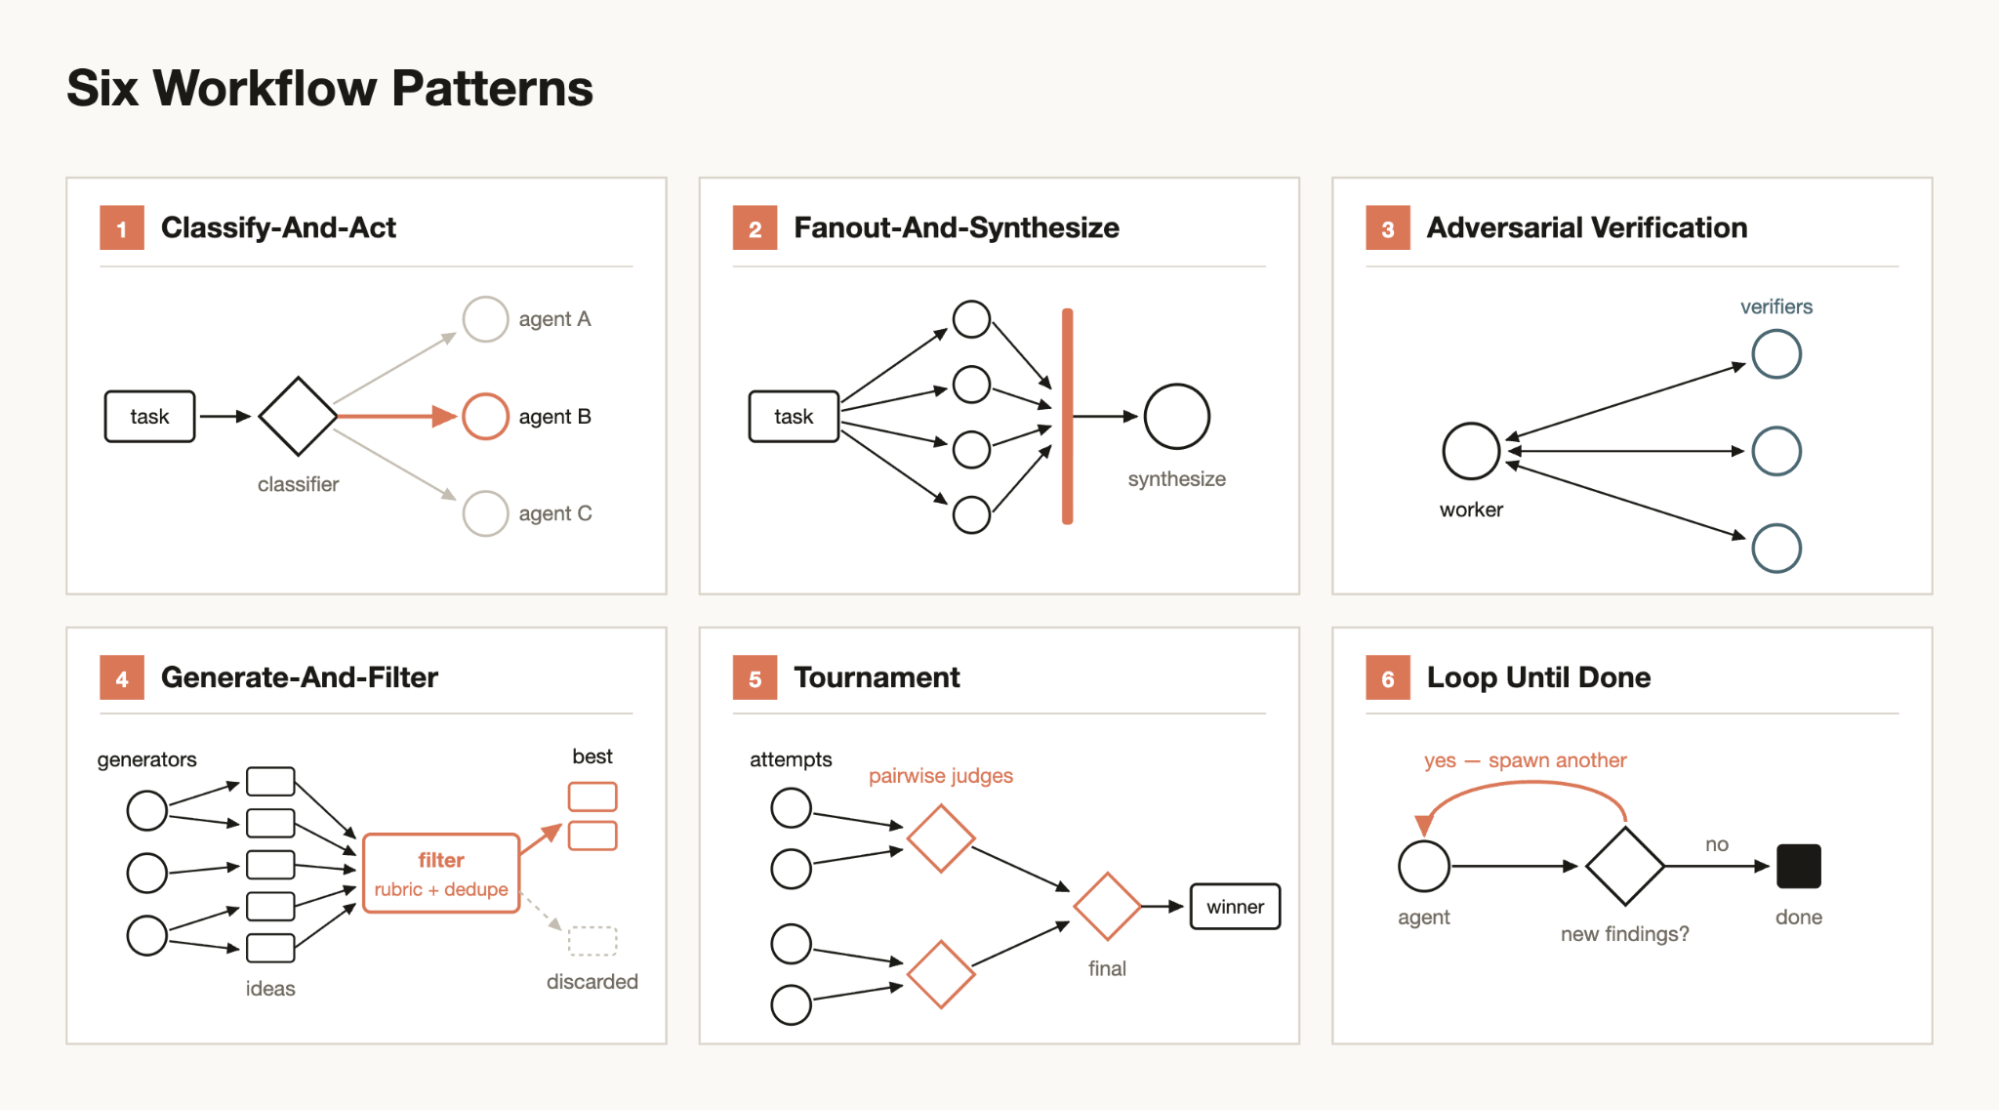
Claude 从中组合的六种工作流模式。
Classify-and-act
用分类 Agent 判定任务类型,再按任务路由到不同 Agent 或行为。或在末尾用分类器判定输出。
Fan-out-and-synthesize
把任务拆成许多更小步骤,每步跑一个 Agent,再综合结果。特别适合小步骤很多,或每步受益于干净上下文窗口、以免互相干扰或交叉污染时。综合步骤是屏障——等所有扇出 Agent,再把结构化输出合成一个结果。
Adversarial verification
对每个生成的 Agent,另跑一个生成的 Agent,对照评分标准或准则对抗式核验其输出。
Generate-and-filter
就某主题生成一批想法,再按评分标准或核验过滤,去重,只返回最高质量、测过的想法。
Tournament
不是分活,而是让 Agent 竞争。生成 N 个 Agent,各自用不同做法尝试同一任务。再用提示词或模型以成对方式经评判 Agent 裁决,直到有赢家。
Loop until done
对工作量未知的任务,循环生成 Agent,直到满足停止条件(没有新发现,或日志里没有更多错误),而不是固定遍数。
使用场景
创造性地想何时、如何让 Claude Code 做动态工作流。我发现工作流有时对非技术工作更有用。
迁移与重构
Bun 用工作流从 Zig 重写到 Rust。可见 Jarred 的线程,或我们如何在百万行代码库上跑 AI 代码迁移。
关键是把任务拆成要对调用点、失败测试、模块等操作的一系列步骤。每个修复在 worktree 里拉一个 subagent 去做,再让另一个 Agent 对抗式审查,然后合并。可考虑告诉 Agent 不要用吃资源的命令,以便最大并行而不把机器资源跑光。
深度研究
我们在 Claude Code 里发布了用动态工作流的深度研究 Skill(/deep-research):扇出网络搜索、抓源、对抗式核验其主张,再综合成带引用的报告。
这类研究不只用于网页搜索。例如让 Claude 从 Slack 上下文汇编状态报告,或通过深入探索代码库研究某功能如何工作。
深度核验
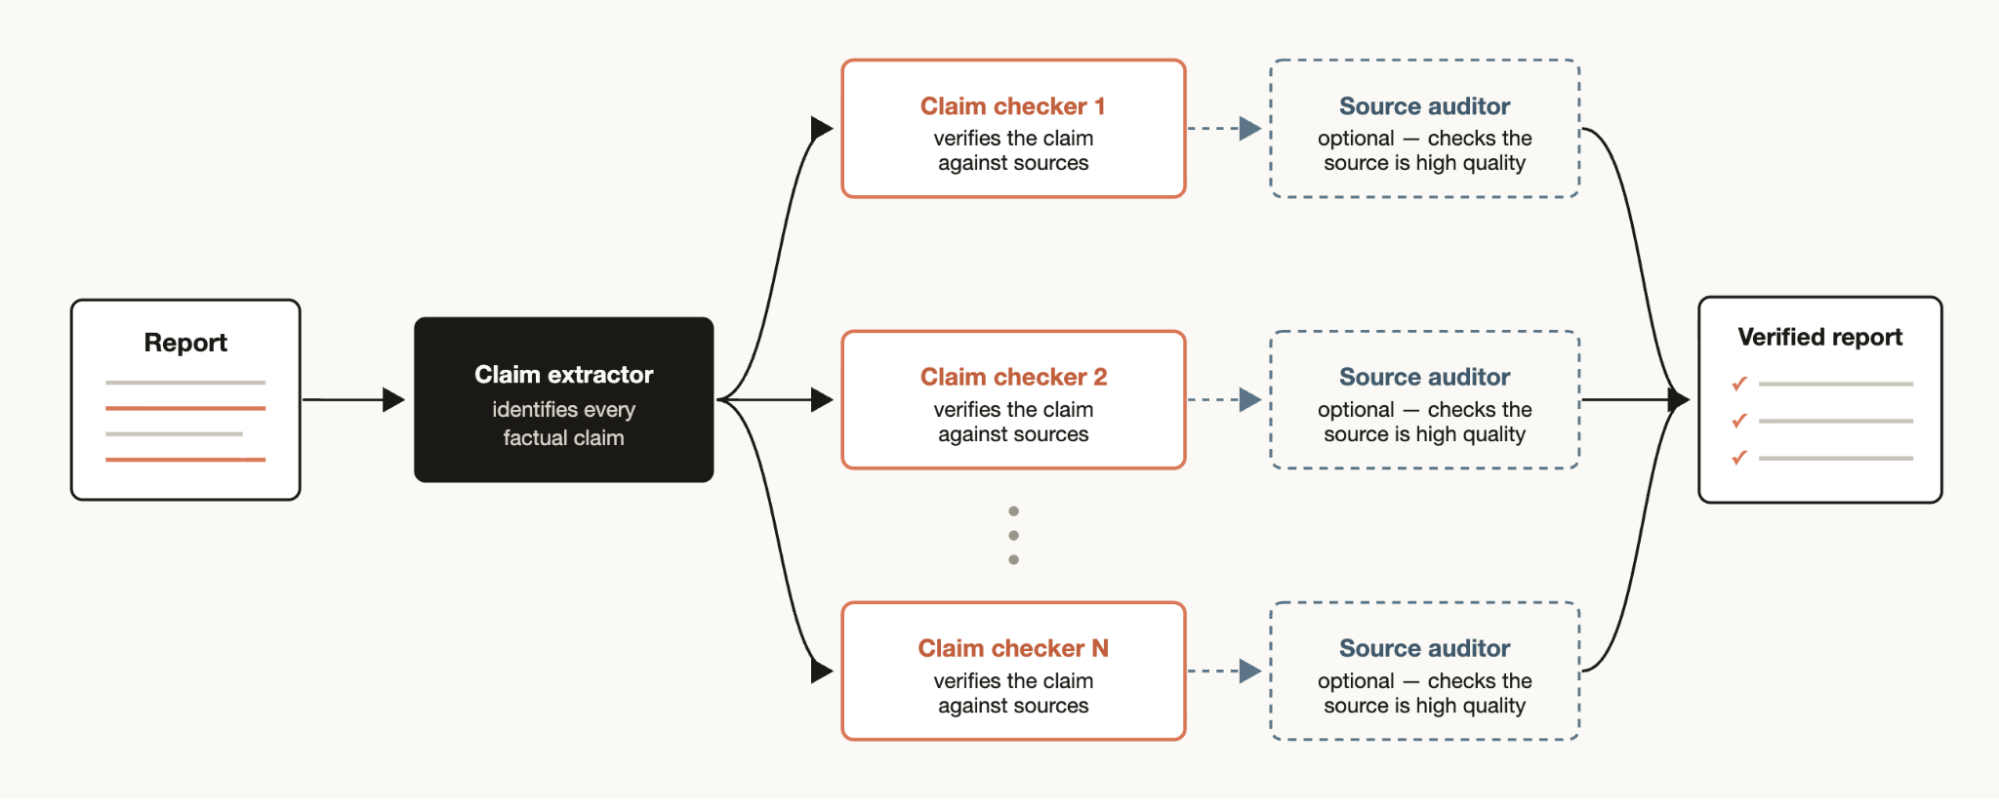
深度核验:每个事实主张一个 checker Agent,可选再跟一个 source auditor。
另一方面,若有一份报告要检查并溯源每条事实主张,可生成工作流:一个 Agent 找出全部事实主张,再为每条拉起 subagent 细查。也可让核验 Agent 检查源 subagent,确保来源质量高。
排序
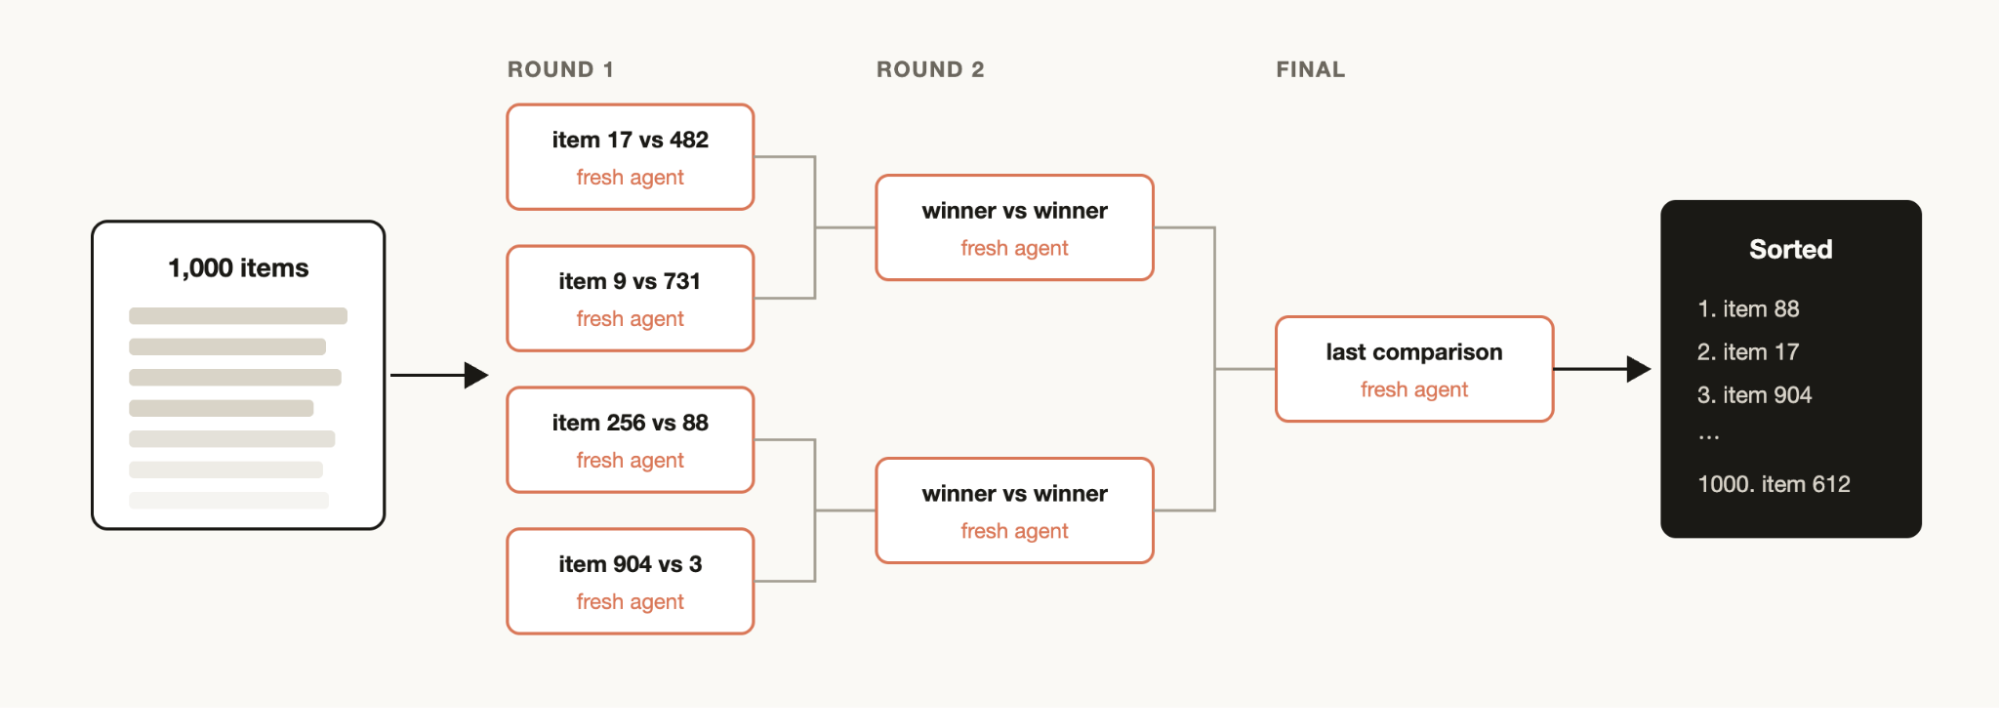
锦标赛排序:每次比较用新 Agent,因此没有单一上下文要装下全部 1000 项。
你可能有一份列表,想按你认为 Claude Code 擅长评估的定性度量排序,例如:按 bug 严重度排支持工单。但一次提示里排 1000+ 行,质量会掉且塞不进上下文。应跑锦标赛、成对比较 Agent 流水线(相对判断比绝对打分更可靠),或并行分桶再合并。每次比较是自己的 Agent,确定性循环持有赛程,上下文里只留当前排序。
记忆与规则遵守
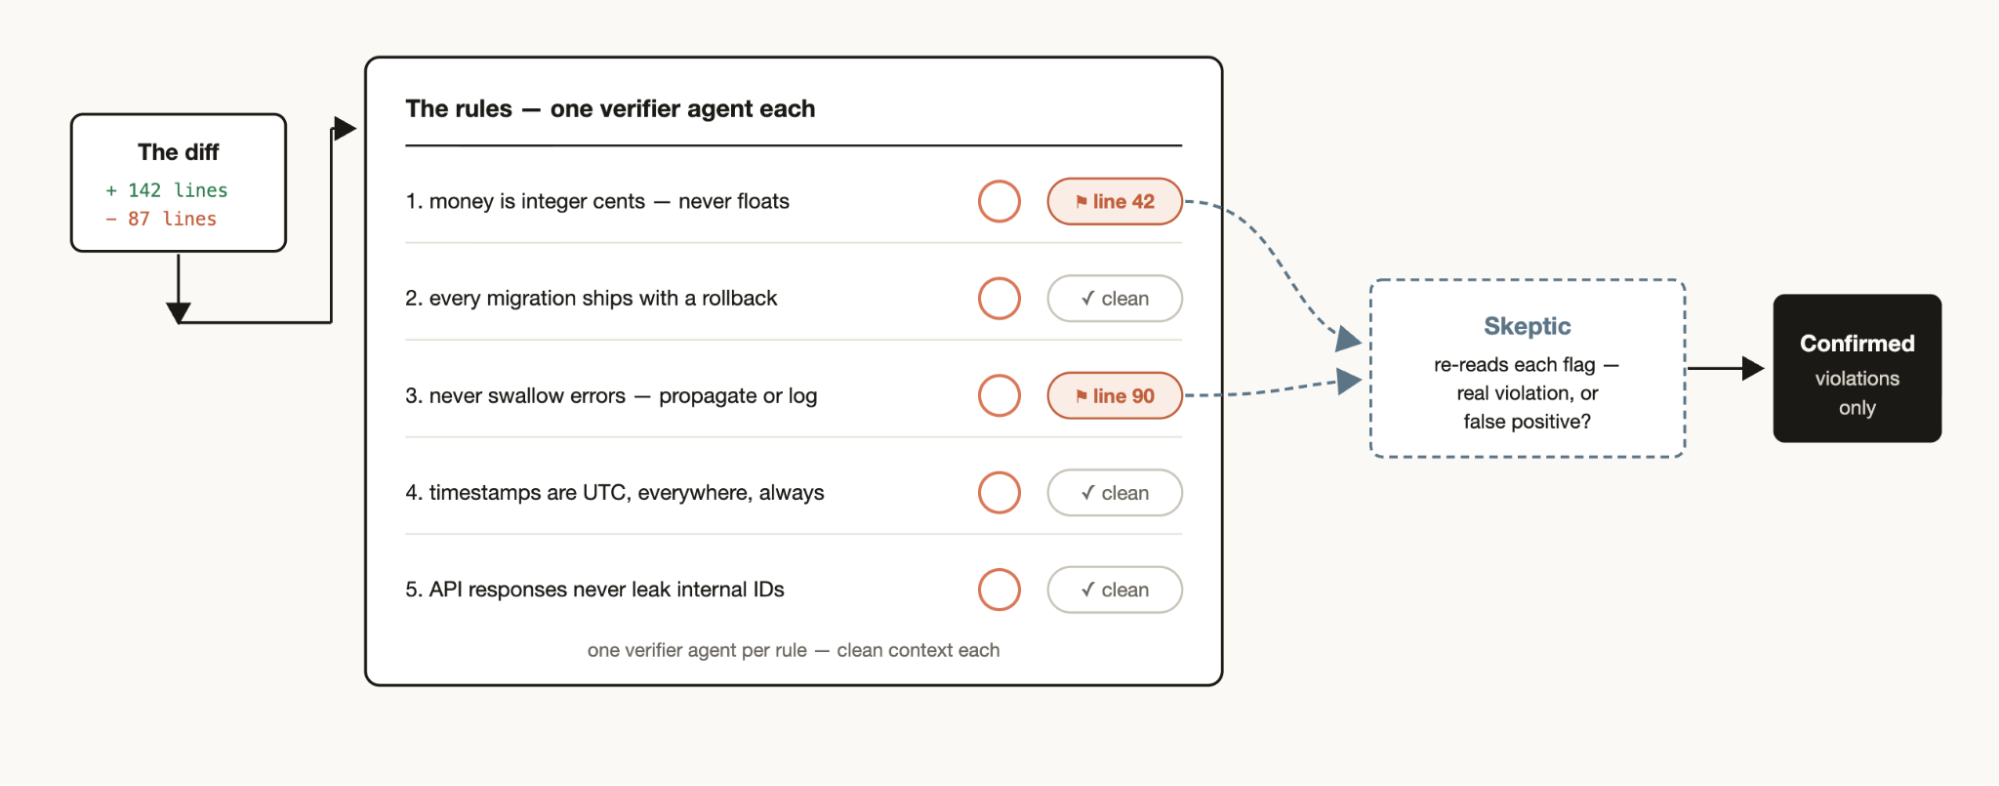
逐条规则审查:每条规则一个干净上下文里的 verifier,再由 skeptic 过滤标记。
若有一套 Claude 即使写进 CLAUDE.md 仍会漏或吃力的规则,做一个工作流,列出必须由 verifier Agent 检查的规则——每条规则一个 verifier。再做一个 skeptic 人设 subagent 审规则是否靠谱,有助于减少误报。
反向也行:从近期会话与代码审查评论挖你反复做的纠正,用并行 Agent 聚类,对抗式核验每个候选(这条规则是否本可防止真实错误?),再把幸存者蒸馏回 CLAUDE.md。
根因调查
调试最好在提出若干独立假设并检验时效果好,但若只用一个上下文窗口,Claude 会撞上自我偏好偏差。
工作流可通过从不相交证据生成假设的 Agent 从结构上防止:例如日志、文件、数据各一个 Agent。每个假设再面对一组 verifier 与 refuter。
不只用于代码。工作流可用于销售(三月销售为何掉?)、数据工程(这条流水线为何失败?),或任何事后分析。
规模化分流
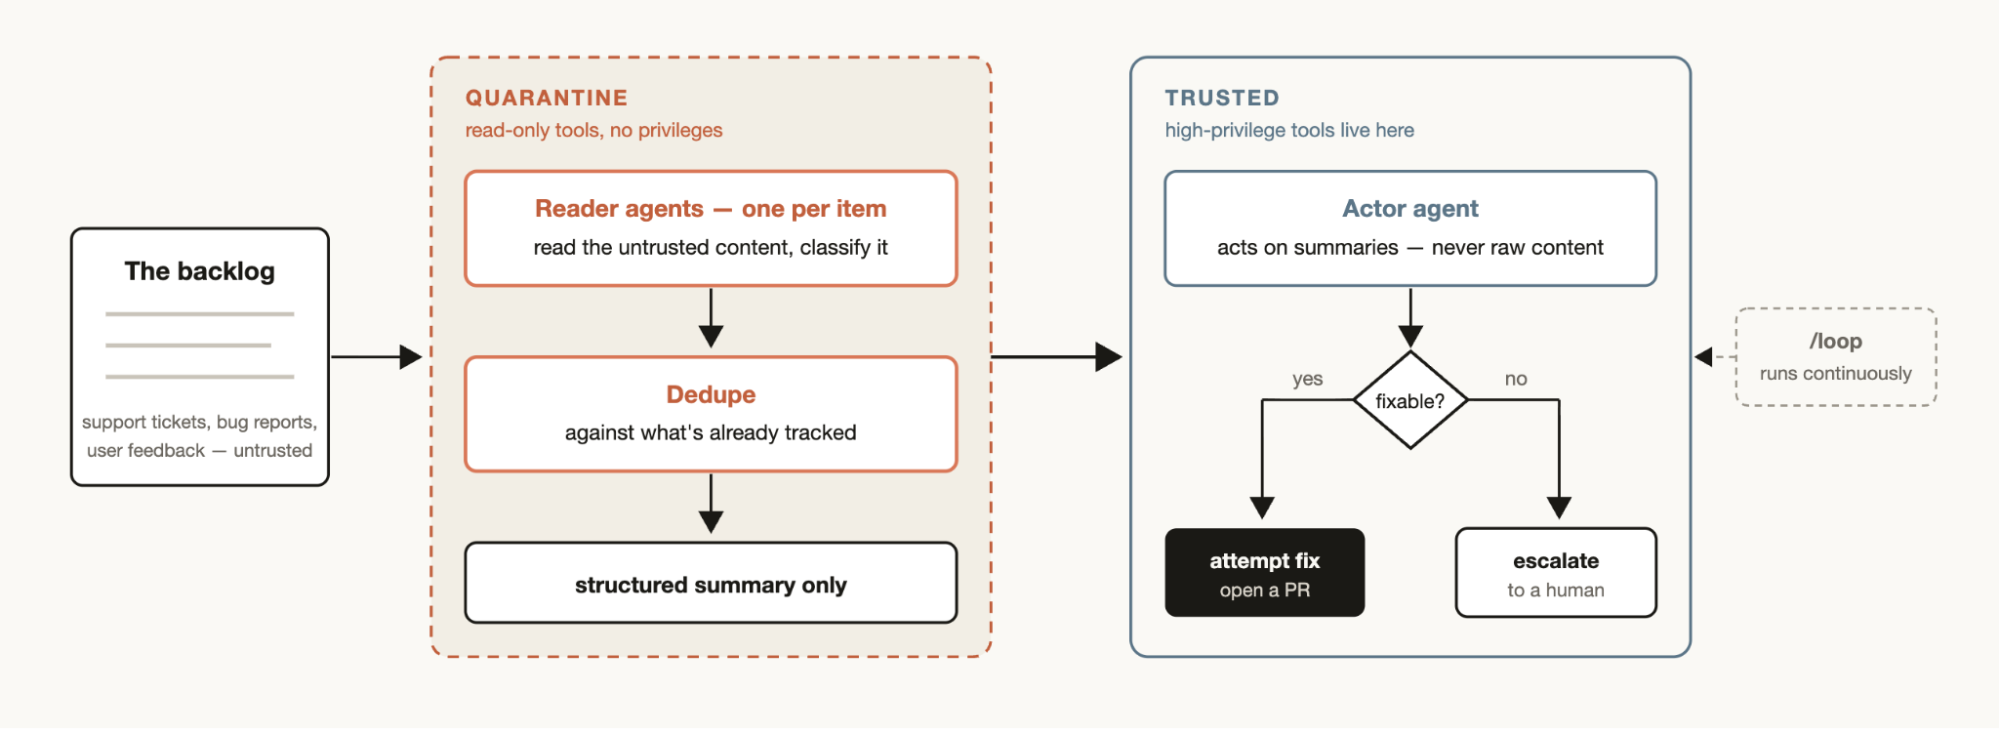
先隔离再行动:reader Agent 用无特权碰不可信内容;actor Agent 只看到它们的摘要。
每个团队都有支持队列、bug 报告或其他人类无法完全处理完的积压。
分流工作流对每项分类、与已跟踪内容去重,并采取行动:尝试修复或升级给人。
分流工作流的有用模式是隔离(quarantine):禁止读不可信公开内容的 Agent 采取高特权行动,改由负责行动的 Agent 来做。
把分流工作流与 /loop 配对,让 Claude 持续做这件事。
探索与品味
在探索不同解法时,工作流有用,尤其是偏品味的(设计、命名),且受益于评分标准时。
可让 Claude 探索一批解法,并给审查 Agent 一份「好解法长什么样」的评分标准。审查 Agent 觉得达标即完成。也可按评分标准用锦标赛排序或选拔。
评测
可为特定任务跑轻量评测:在 worktree 里拉起独立 Agent,再拉起比较 Agent,对照评分标准比较并打分具体输出。例如 评测并 refining 你做的某个 Skill,对照特定准则。
模型与智力路由
做一个按你的任务调好的分类 Agent,决定用哪个模型。任务会涉及大量工具调用、且执行前做研究能找出最合适模型时,这很有用。
例如「解释 auth 模块怎么工作」的最佳模型,取决于 auth 模块有多少文件以及代码库形状。分类 Agent 可做这研究,再按预期复杂度 路由到 Sonnet 或 Opus。
何时不用动态工作流
工作流还新。虽有许多用例能产生超常结果,但不是每件事都需要,且可能显著多花 token。
最好创造性地用工作流,把 Claude Code 推到你以前没试过的地方。对常规编码任务,先问:真的需要更多算力吗?例如多数传统编码任务不需要 5 人审查小组。
同样判断也适用于上一层架构:多 Agent vs 单 Agent 的决策逻辑类似——并行与专业化必须挣回协调成本。
构建动态工作流的技巧
提示词
对动态工作流用上文那些具体技巧做详细提示,效果最好。
工作流不只用于大任务。可提示模型用「快速工作流」。例如对某个假设做快速对抗式审查。
与 /goal 和 /loop 组合
对可重复的工作流(如分流、研究、核验),与 /loop 配对以 按固定间隔跑,并用 /goal 设硬完成条件。
Token 用量预算
可为动态工作流设显式 token 用量预算,限制任务用多少 token。可提示预算如:「用 10k token」,即设上限。
保存与分享动态工作流
在工作流菜单按「s」可保存。可检入 ~/.claude/workflows,或经 Skill 分发。
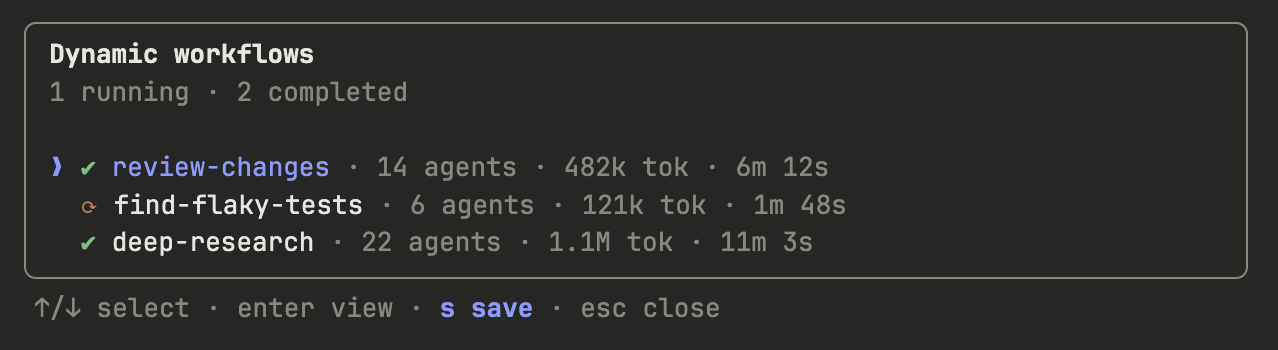
动态工作流面板——按 s 把一次运行存成可复用工作流。
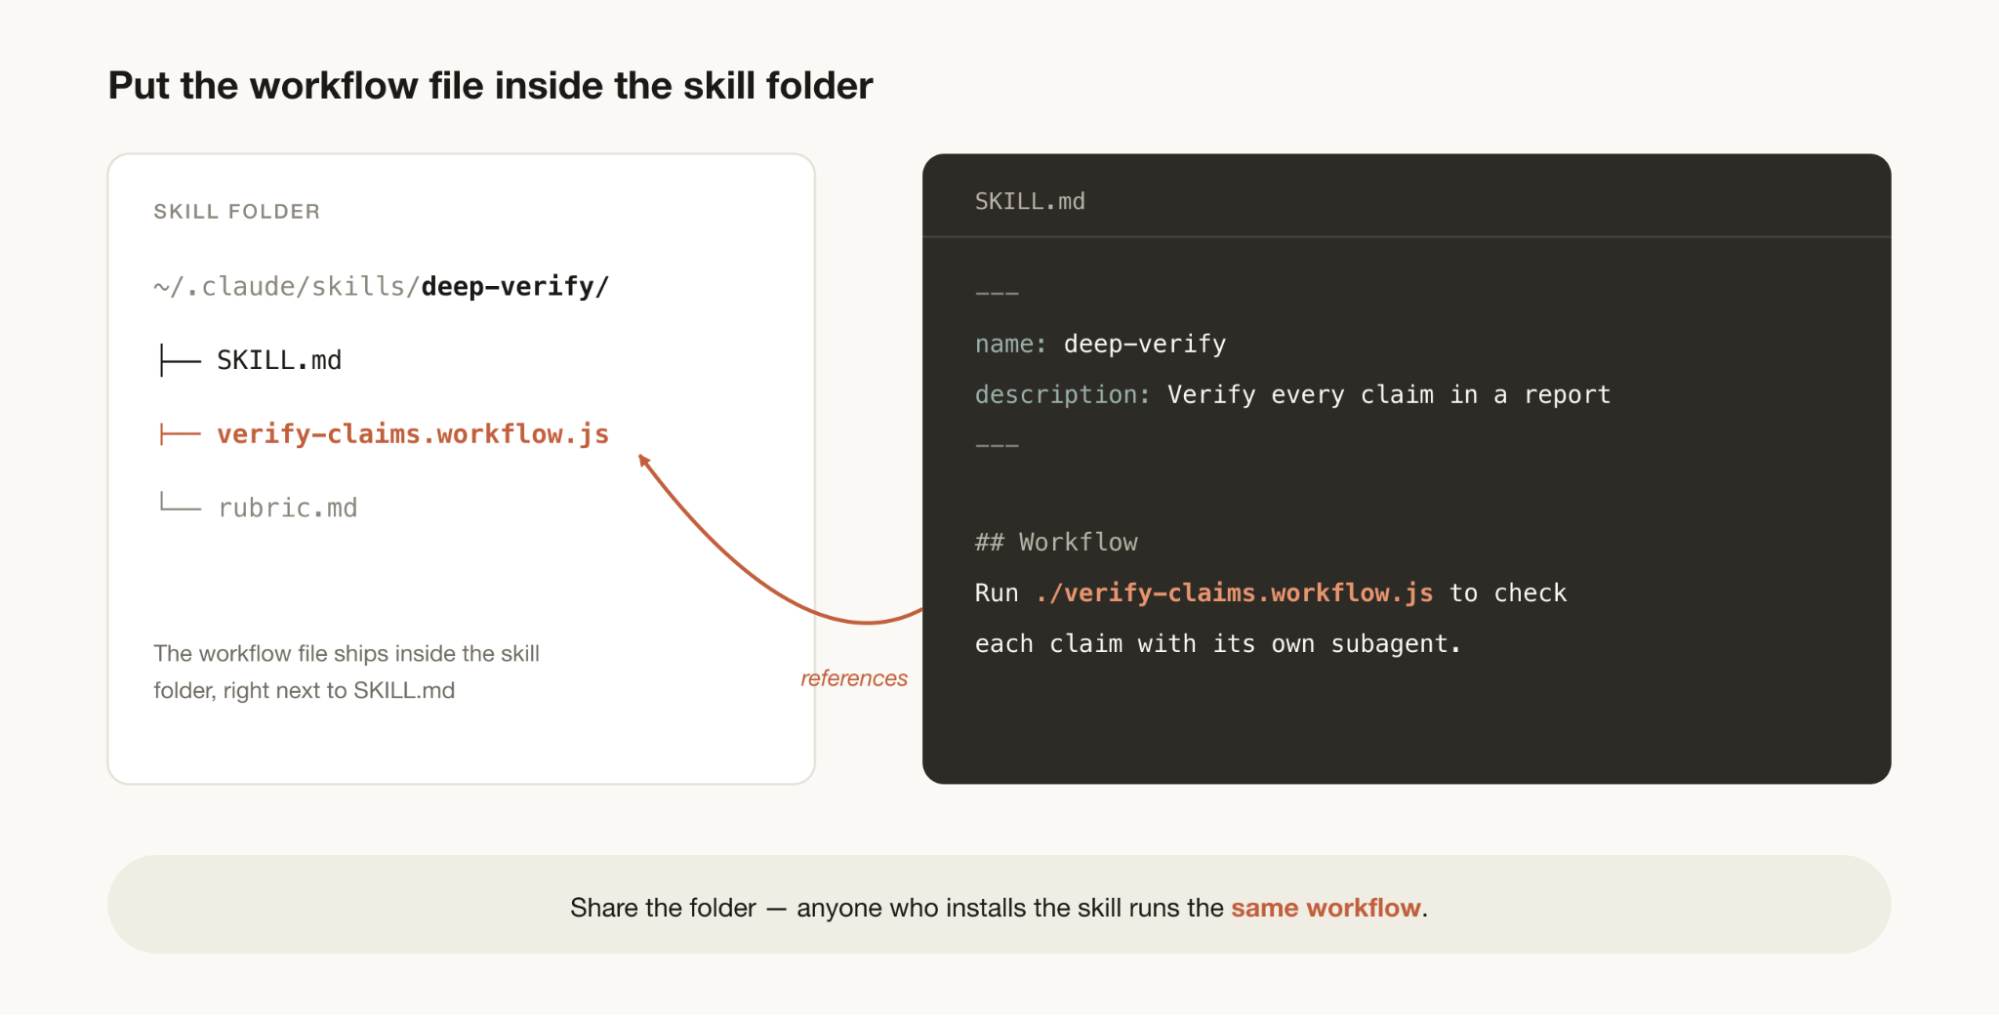
经 Skill 分享时,把 JavaScript 工作流文件放进 Skill 文件夹,并在 SKILL.md 里引用。为更灵活,可提示 Claude 把 Skill 里的工作流当模板,而不是必须原样跑的脚本。
发现的新起点
工作流是扩展 Claude Code 的有用新方式。我鼓励你把它们当作起点,探索用 Claude 完成任务的新方法。怎样用得最好仍有许多可发现。告诉我你找到了什么。
关于 harness 里首先该放什么,见我们为用 Claude 构建整理的三条 harness 设计模式。
本文作者 Thariq Shihipar 与 Sid Bidasaria,Anthropic Members of Technical Staff,负责 Claude Code。