评测给出应用或 Skill 在特定任务上的表现信号。但设计评测,以及在不自欺的前提下提升表现,很难。我们把这两方面的指引加进了 claude-api Skill。
有了该 Skill,可运行 /claude-api build-eval 在代码库内建评测,再运行 /claude-api hillclimb 一次改一项地提升应用,并用留出集抓住过拟合。
本文先讲好评测设计与爬山迭代的原则,再展示 Claude Code 配合 claude-api Skill 如何应用这些原则,最后给几条命令示例。
评测设计
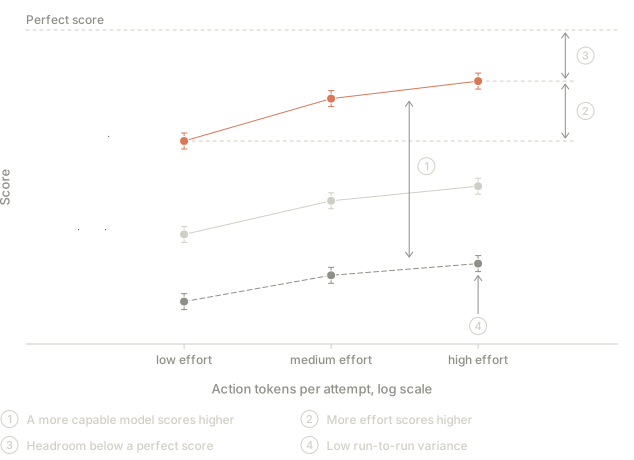
设计良好的评测有几个共同点(图 1):
- 评测任务镜像生产。 采样你在「生产」——即被测能力或应用会被用到的场景——里真正关心的任务。有时任务被选中是因为好生成或好打分。但重要的是任务分布代表你真正关心的东西。
- 更强模型与更多思考时表现更好。 更有能力的模型与 更高 effort 档位 通常应在评测上更好。若不是,往往是任务含糊或打分器标定不准在拖后腿。
- 前沿仍有「可过」的余量。 最强模型、最高 effort 在评测上应明显低于 100%,否则很难可靠判断改动如何影响表现。重要的是:缺口不应由不可能或含糊的任务解释——常见信号是某任务不论重复多少次每次评测都失败。好任务是:两位领域专家会得出同一裁决,且打分器检查的一切都写在任务里。
- 运行间方差低。 高方差常来自设计差、含糊的任务,或对相同输出给出不同裁决的打分器。方差也可能藏在配置里,例如 effort 未 consistently 应用。环境也会影响结果:先前试验留下的状态(文件、git 历史)可能把答案递给 Agent。
图:较小、中等与最强模型在 low / medium / high effort 下,分数相对每次尝试的 action token。编号标注四点:分数随更强模型与更高 effort 上升,顶线仍低于满分,误差棒保持紧。
好评测的四个要素
对抗采样
模型能力是 jagged 的。若因今天的模型失败而挑用例,你是在采某个模型能力曲面的谷(图 2)。评测最终可能在量那个模型的失败指纹,而不是你的应用本质上难或有价值的事。
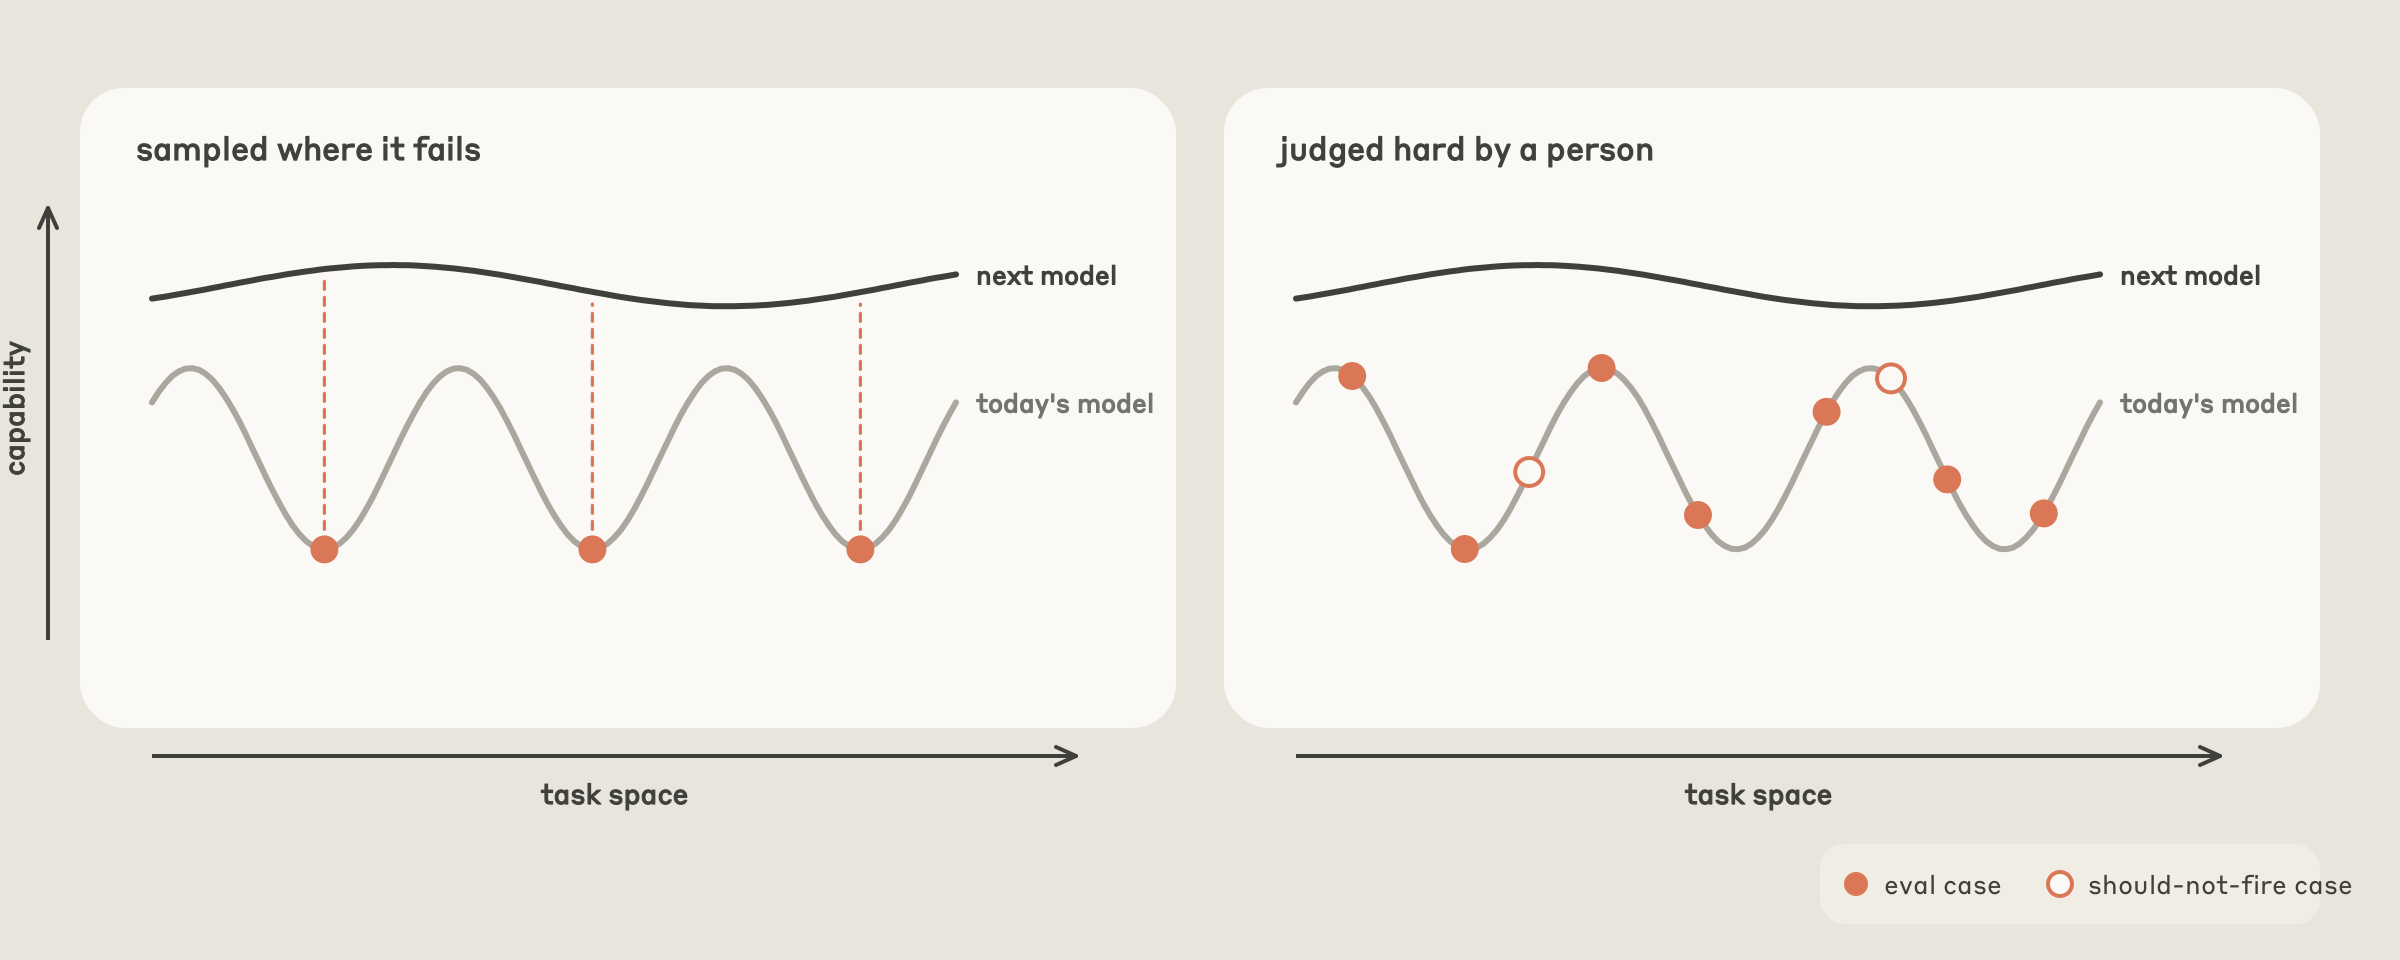
对抗采样
挑难用例是因为人判断它们难:有用的检验是纳入前能说出为何难。纳入来自生产流量、bug 报告或 ticket 的、你应用里具体的失败。但不要盲目信用户流量:用户有时只试他们预期能成功的,严格从用户流量抽的任务分布可能偏易。
/claude-api build-eval
claude-api Skill 里的 build-eval 命令把这些原则变成引导式工作流。在 Claude Code 里跑 /claude-api build-eval 时,Claude 采访你、在代码库内建评测,并在特定点暂停请你批准。
设计用例
Claude 按此顺序帮你采样输入以建评测:
- 生产 transcript(先问留存与敏感数据)
- Bug 报告与支持 ticket
- 你手写的五到十个用例
- 从代码库合成的用例
Skill 优先生产流量,也能从你提供的少量真实例子锚定生成合成数据。Skill 指示 Claude 生成简单页面展示每个输入,等你确认。作为示意,下图是 Skill 可能请用户审阅的邮件路由应用输入集(图 3)。
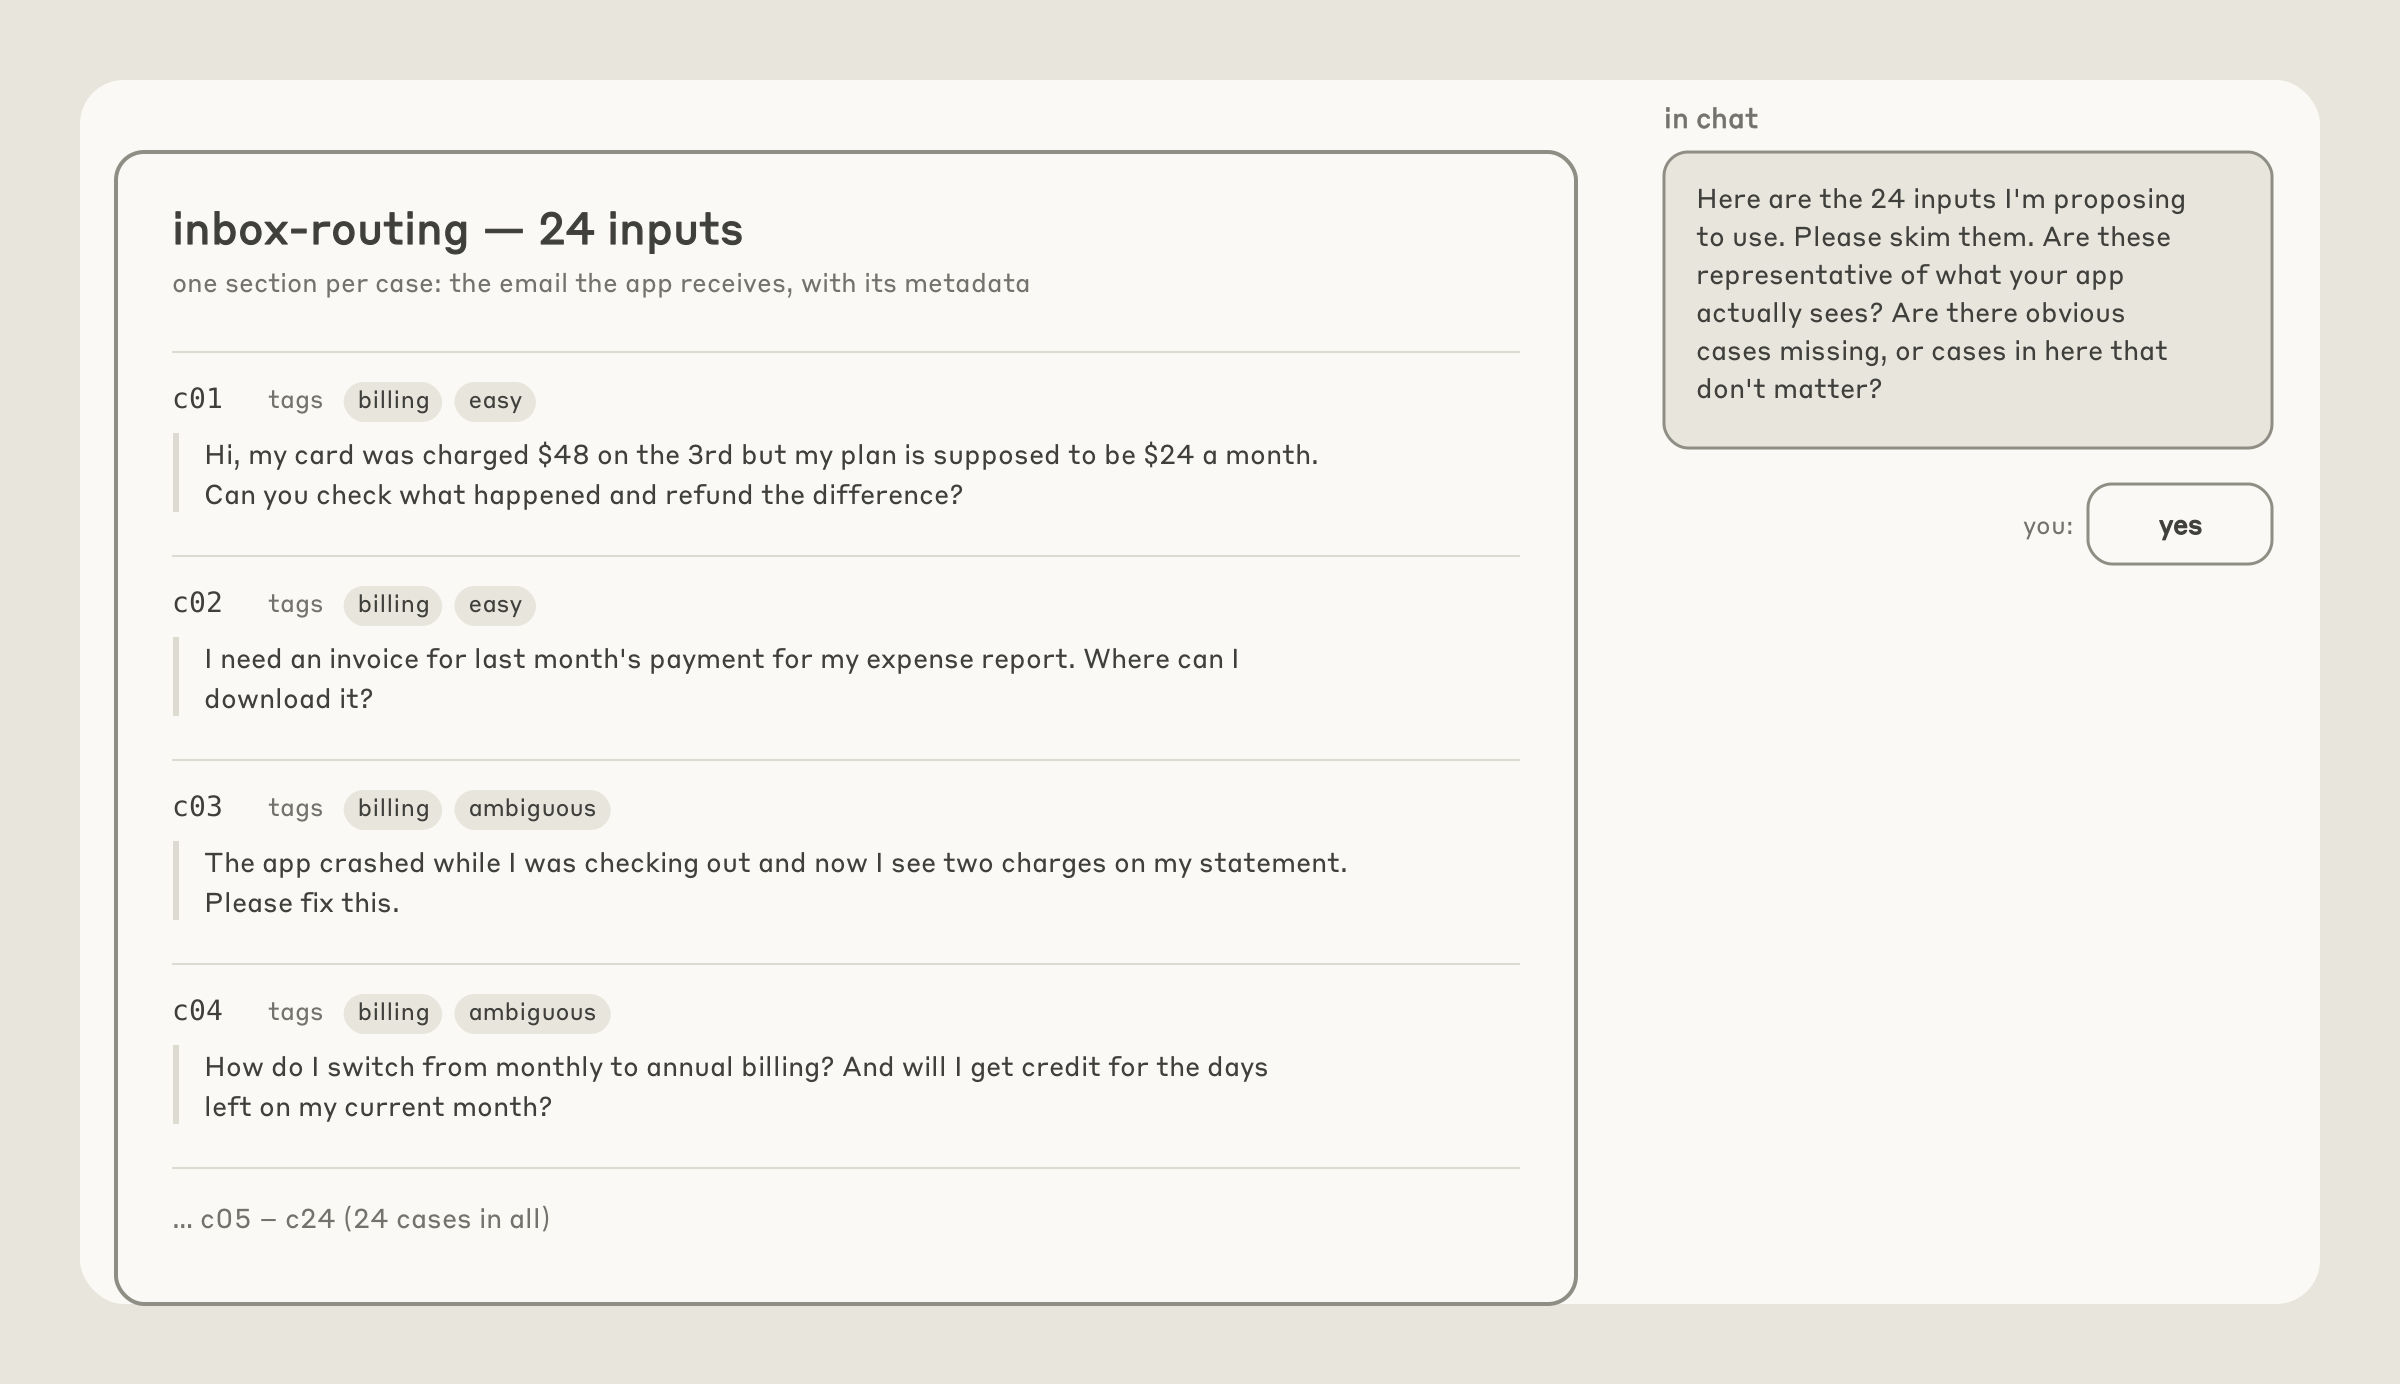
Skill 生成的示例输入审阅页
校验打分器
输入之后,Claude 提议最便宜、又适合你应用输出的打分器:
- 程序化核验:若输出可能性受限,用基于代码的检查(精确匹配、固定集合中的标签、匹配 schema 的 JSON、通过的测试)。
- LLM-as-judge:输出空间开放、有效答案很多但有清晰质量准则时默认用这类。此时第二个模型读输入、输出与写成可检查主张的评分标准(不是 1–5 分制),返回分数与理由。若有基线可比较,评判者改为随机顺序读两边输入、不被告知哪个是基线,并挑更好的。由你选评判模型,且不应是被测模型。
Claude 给少量用例打分,并问你会否给其中任何一项打不同分(图 4)。一般应在相信评测器之前 读一批已打分 transcript;打分失败是评测配置错误最常见的方式之一。
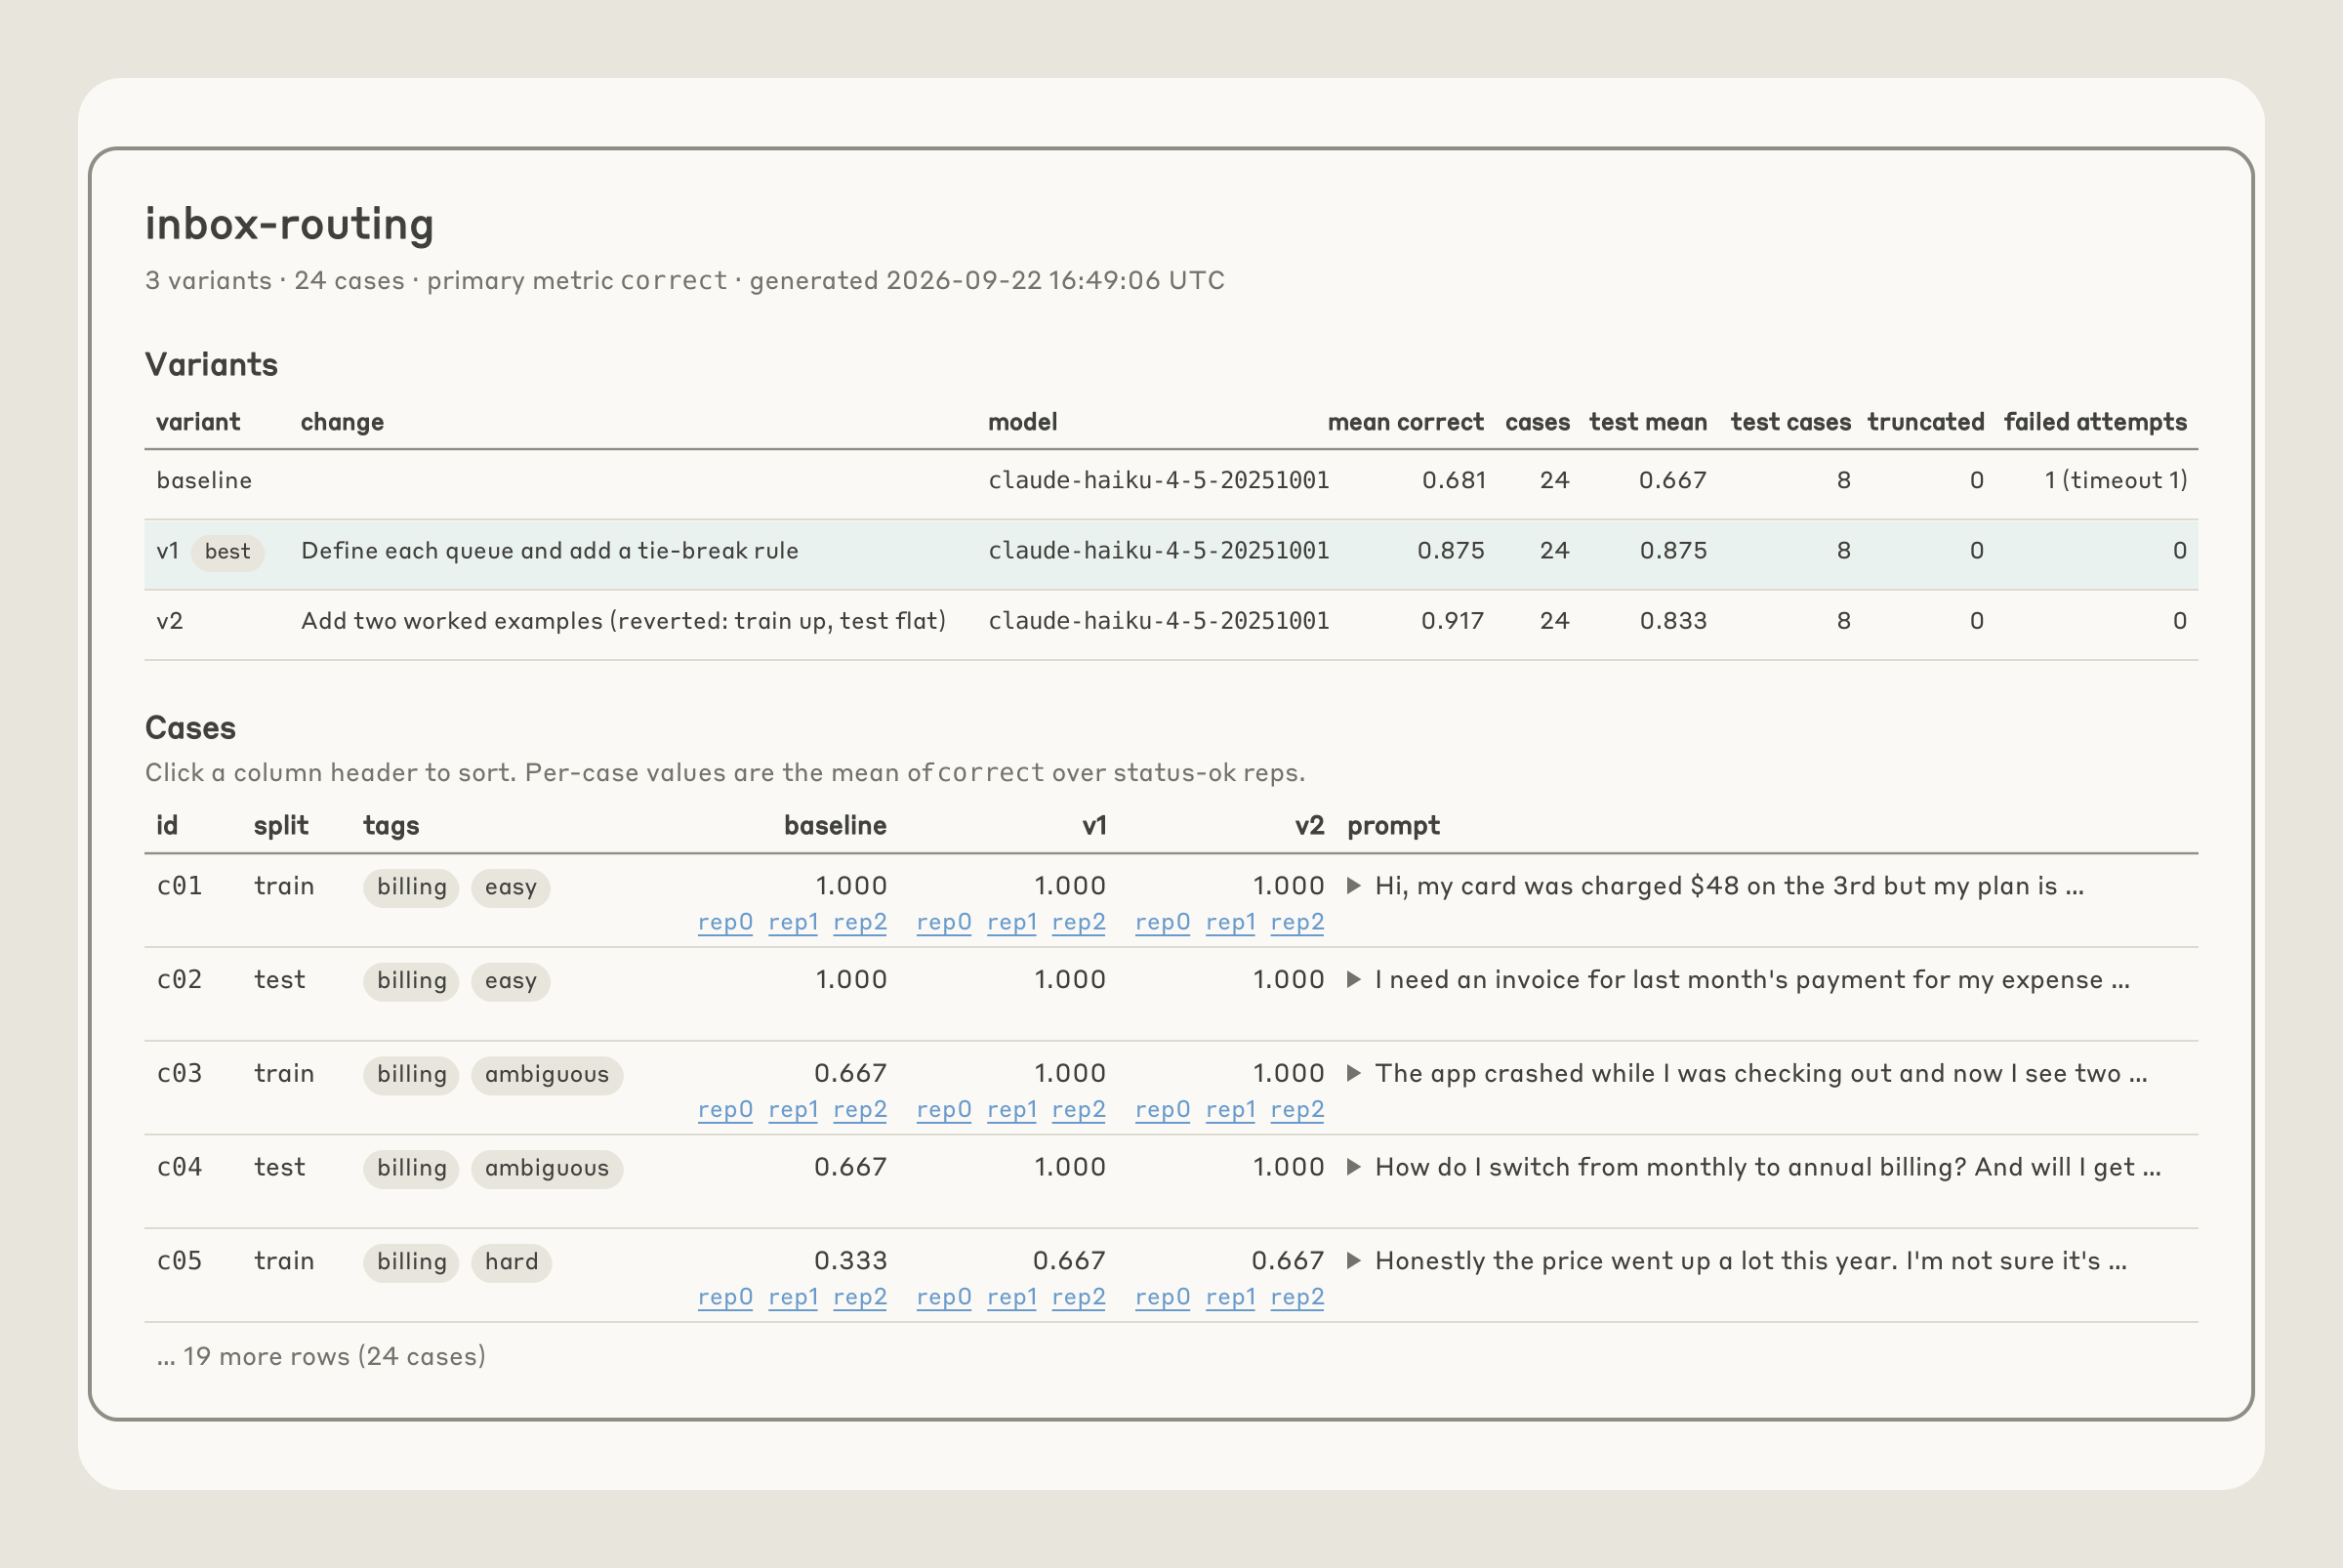
校验打分器后,Skill 告诉你评测集规模(用例 × 重复 × 模型,以及大约多久),跑基线,并打印带置信区间的分数。你得到:用例、打分器、runner、每用例一行 JSON 与一份完整 transcript,以及列出每用例分数并链到 transcript 的朴素页面。若要更多(如图表),直接问,Claude 会在旁边再做一页。默认这些额外页是本地打开、不从网络加载的静态文件。
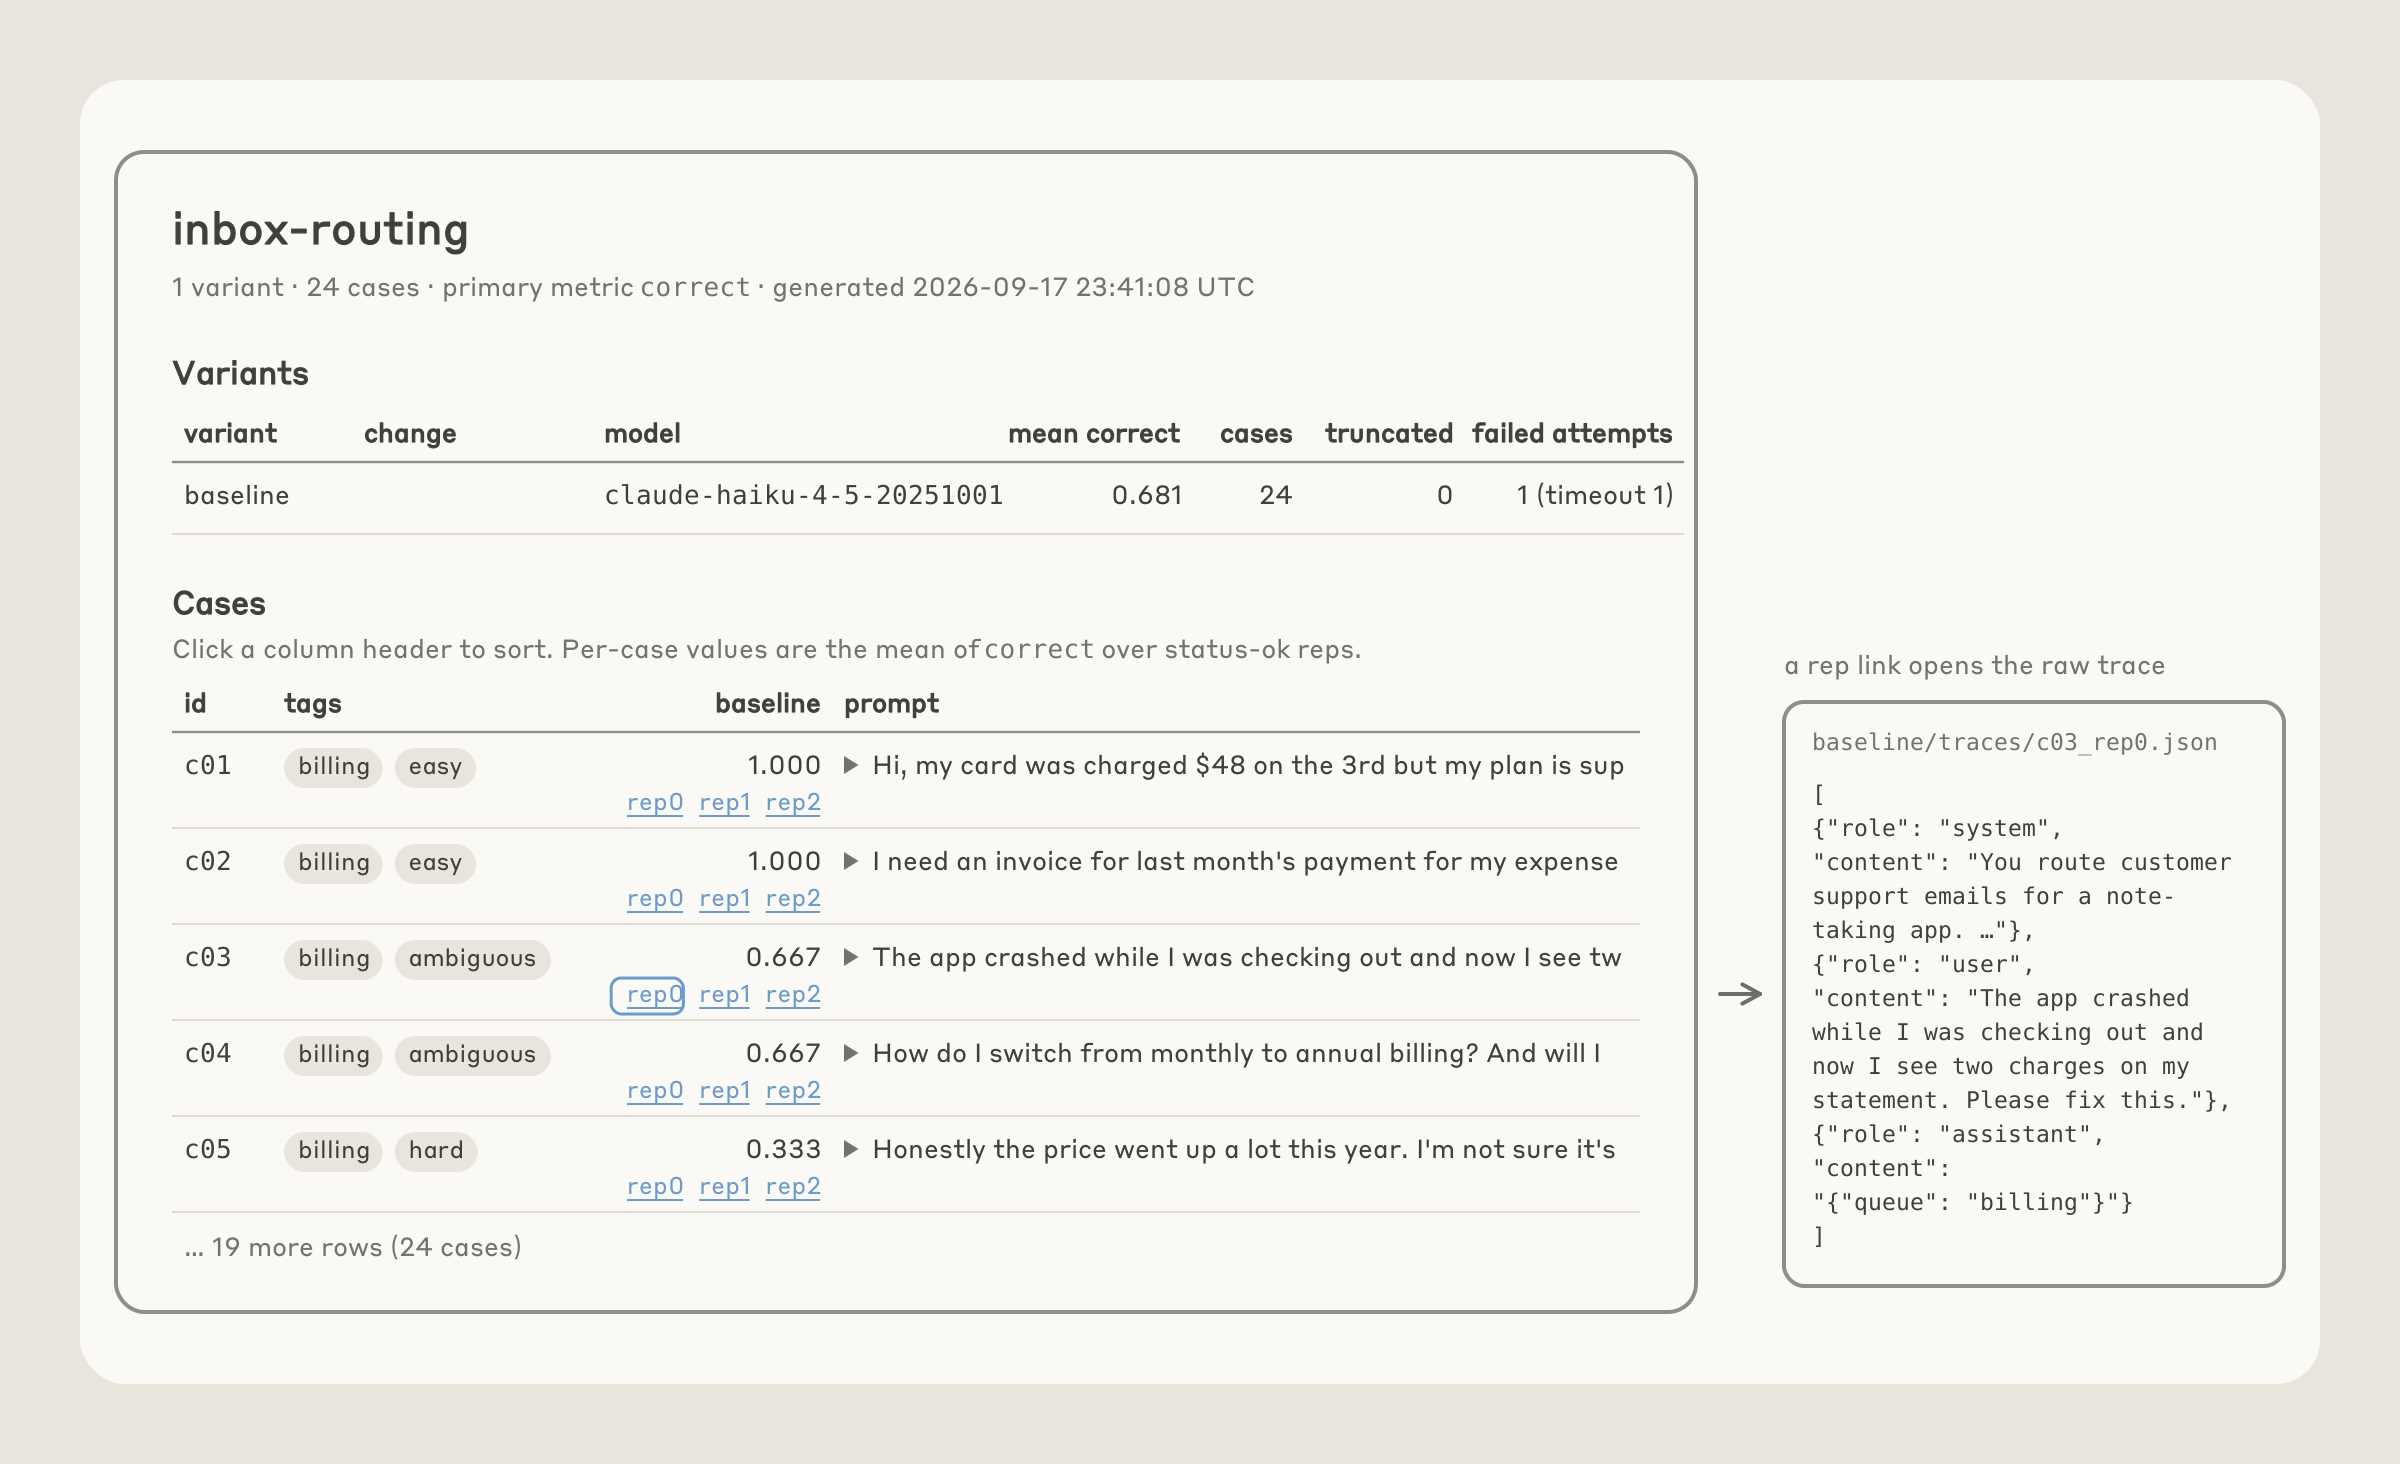
带建议分数的结果页示意。
诊断检查
上述基线运行中,Claude 检查若干事项:
- 打分器:对同一输出跑两次打分器,报告裁决是否变化。
- 管道:检查超时、API 错误与截断答案,确保基础设施噪声不当成模型方差。
- 余量:若基线已约 95% 或更高,Skill 警告用户,并提示爬山迭代应探索成本或延迟而非质量。
爬山迭代
有了可靠的任务表现打分方式后,可以试着提升。爬山迭代是调 effort 或提示词等在成本与表现间权衡的参数的有效方式。选择应用面的一般建议:
- 便宜迭代 — 修改你聚焦爬山迭代的表面,应在时间、成本与精力上便宜。许多内部项目与客户把爬山迭代聚焦在文本上,如提示词与 Skills,容易改也容易回退。相对地,爬山迭代中对 Agent harness 做开放式修改可能涉及大量代码改动。
- 可归因 — 评测分数变化应可归因于你在爬山迭代中修改的表面。例如,若干成功应用聚焦 Skill 触发。评测指标(Skill 触发率)直接耦合到被改的 Skill 描述。
- 目标范围清楚 — 常见失败是开放式要求提升表现,却没仔细想评测里还有多少余量;接近饱和的评测或范围差的表面(例如开放式要求更新 harness)更容易卡住。跨多种努力普遍较强的目标是成本:即使评测已饱和,也可让 Claude 在保持表现持平的同时找降本办法。
过拟合
即使设计良好的评测也很少与你在生产真正关心的任务分布完全一致。因此「过拟合」评测是常见问题,导致系统在评测上比在生产流量上更好。
评测有许多方式可「泄漏」进 harness——即模型周围的代码,含提示词、工具,以及调用 Claude 的循环。例如某评测任务受益于 OCR,但生产任务很少需要 OCR。评测 harness 可能给应用加 OCR 工具,基准上去了,对生产却无影响。更广地说,爬山迭代可能给 harness 加功能,专门应对你选中的评测用例的边界情况。这些 harness 增补抬高评测分,却不转化为生产改进(图 5)。
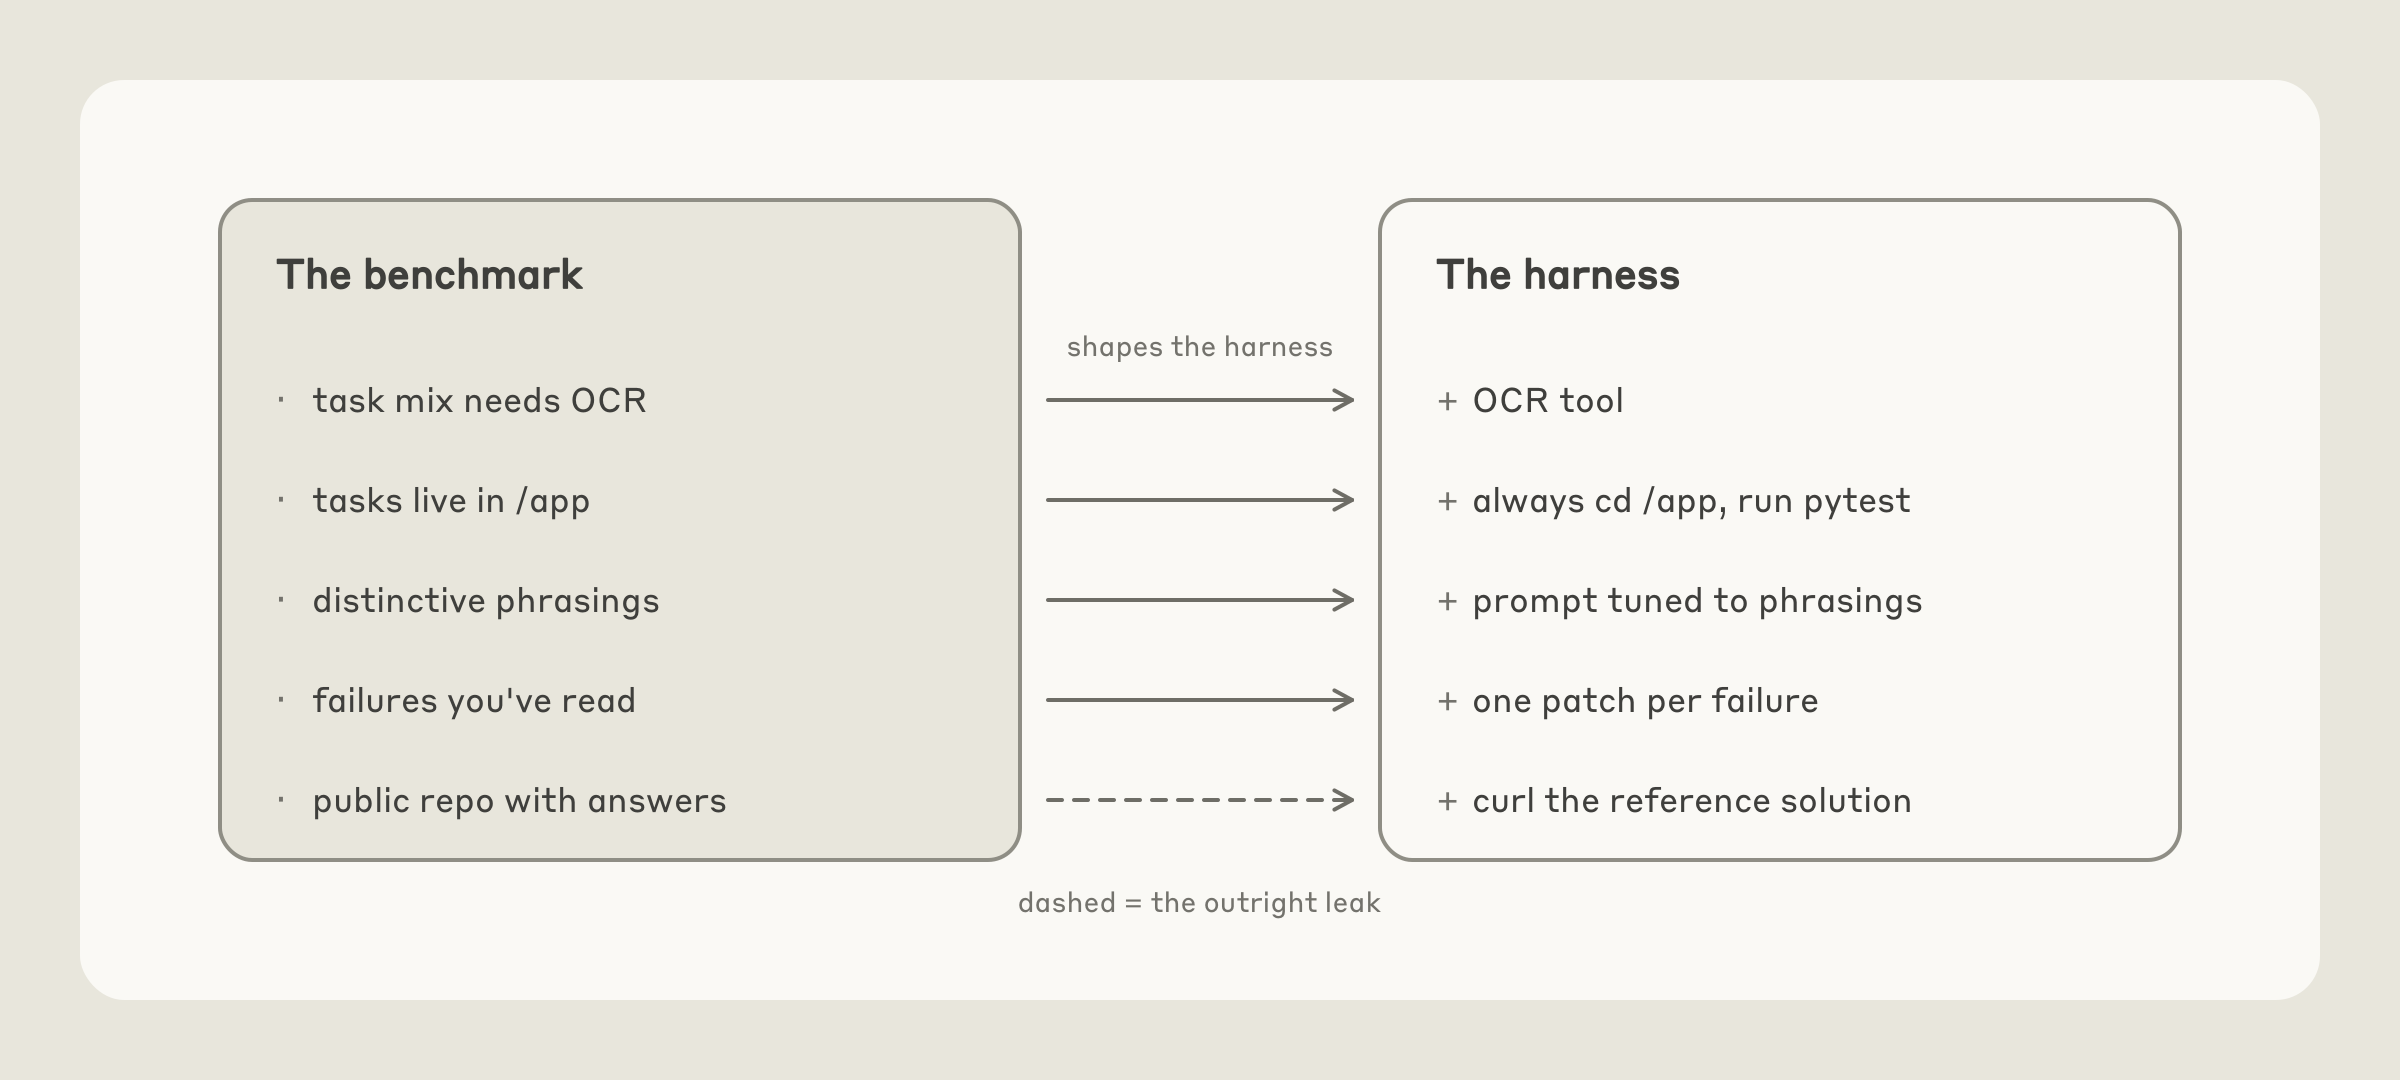
Harness 过拟合的常见原因。
三件事有助于应对:
- 拆分用例。 用爬山迭代者可读的 train 集,与永不见面的 test 集。若 train 分升、test 分平,是常见过拟合警告。
- 永不把失败贴进提示词。 若爬山迭代者读失败 transcript,绝不应把失败内容贴进提示词。
- 让答案在结构上够不到模型。 模型有时会「reward hack」,直接找到评测答案。
如下文所述,claude-api Skill 会替你应用这些原则。
/claude-api hillclimb
claude-api Skill 里的 hillclimb 命令把这些原则变成引导式工作流。在 Claude Code 里跑 /claude-api hillclimb 时,Claude 迭代提升给定评测。你选择它能改什么,包括:
- 系统提示词
- Skills 或说明文件
- 工具描述
- 模型选择、effort 档位及其他 API 参数
- 你的 harness 代码
开始前,Claude 问你想优化什么(例如表现,或表现持平时的成本),再随机把评测集拆成 test 与 train。若目标是成本,它会考虑 若干常见成本驱动因素,包括提示词缓存、审计提示词与所选模型的兼容性,以及挑选模型与 effort。
第一轮前,Claude 检查评测噪声(分数仅因偶然能移动多远)是否小于你会采取行动的最小改进;若不是,会说明并建议更多重复或用例。
每轮 Claude 读上一轮 train transcript,提议一处补丁式改动。每轮瞄准效果能高出评测噪声的改动:在根上修失败行为(例如重写导致它的段落或补缺失规则),而不是改几个词。然后用打过补丁的改动跑评测。此时 Claude 做检查:若 train 升而 test 平,怀疑过拟合并回退补丁。若有回归,回退。若 train 与 test 都升,保留补丁(图 6)。
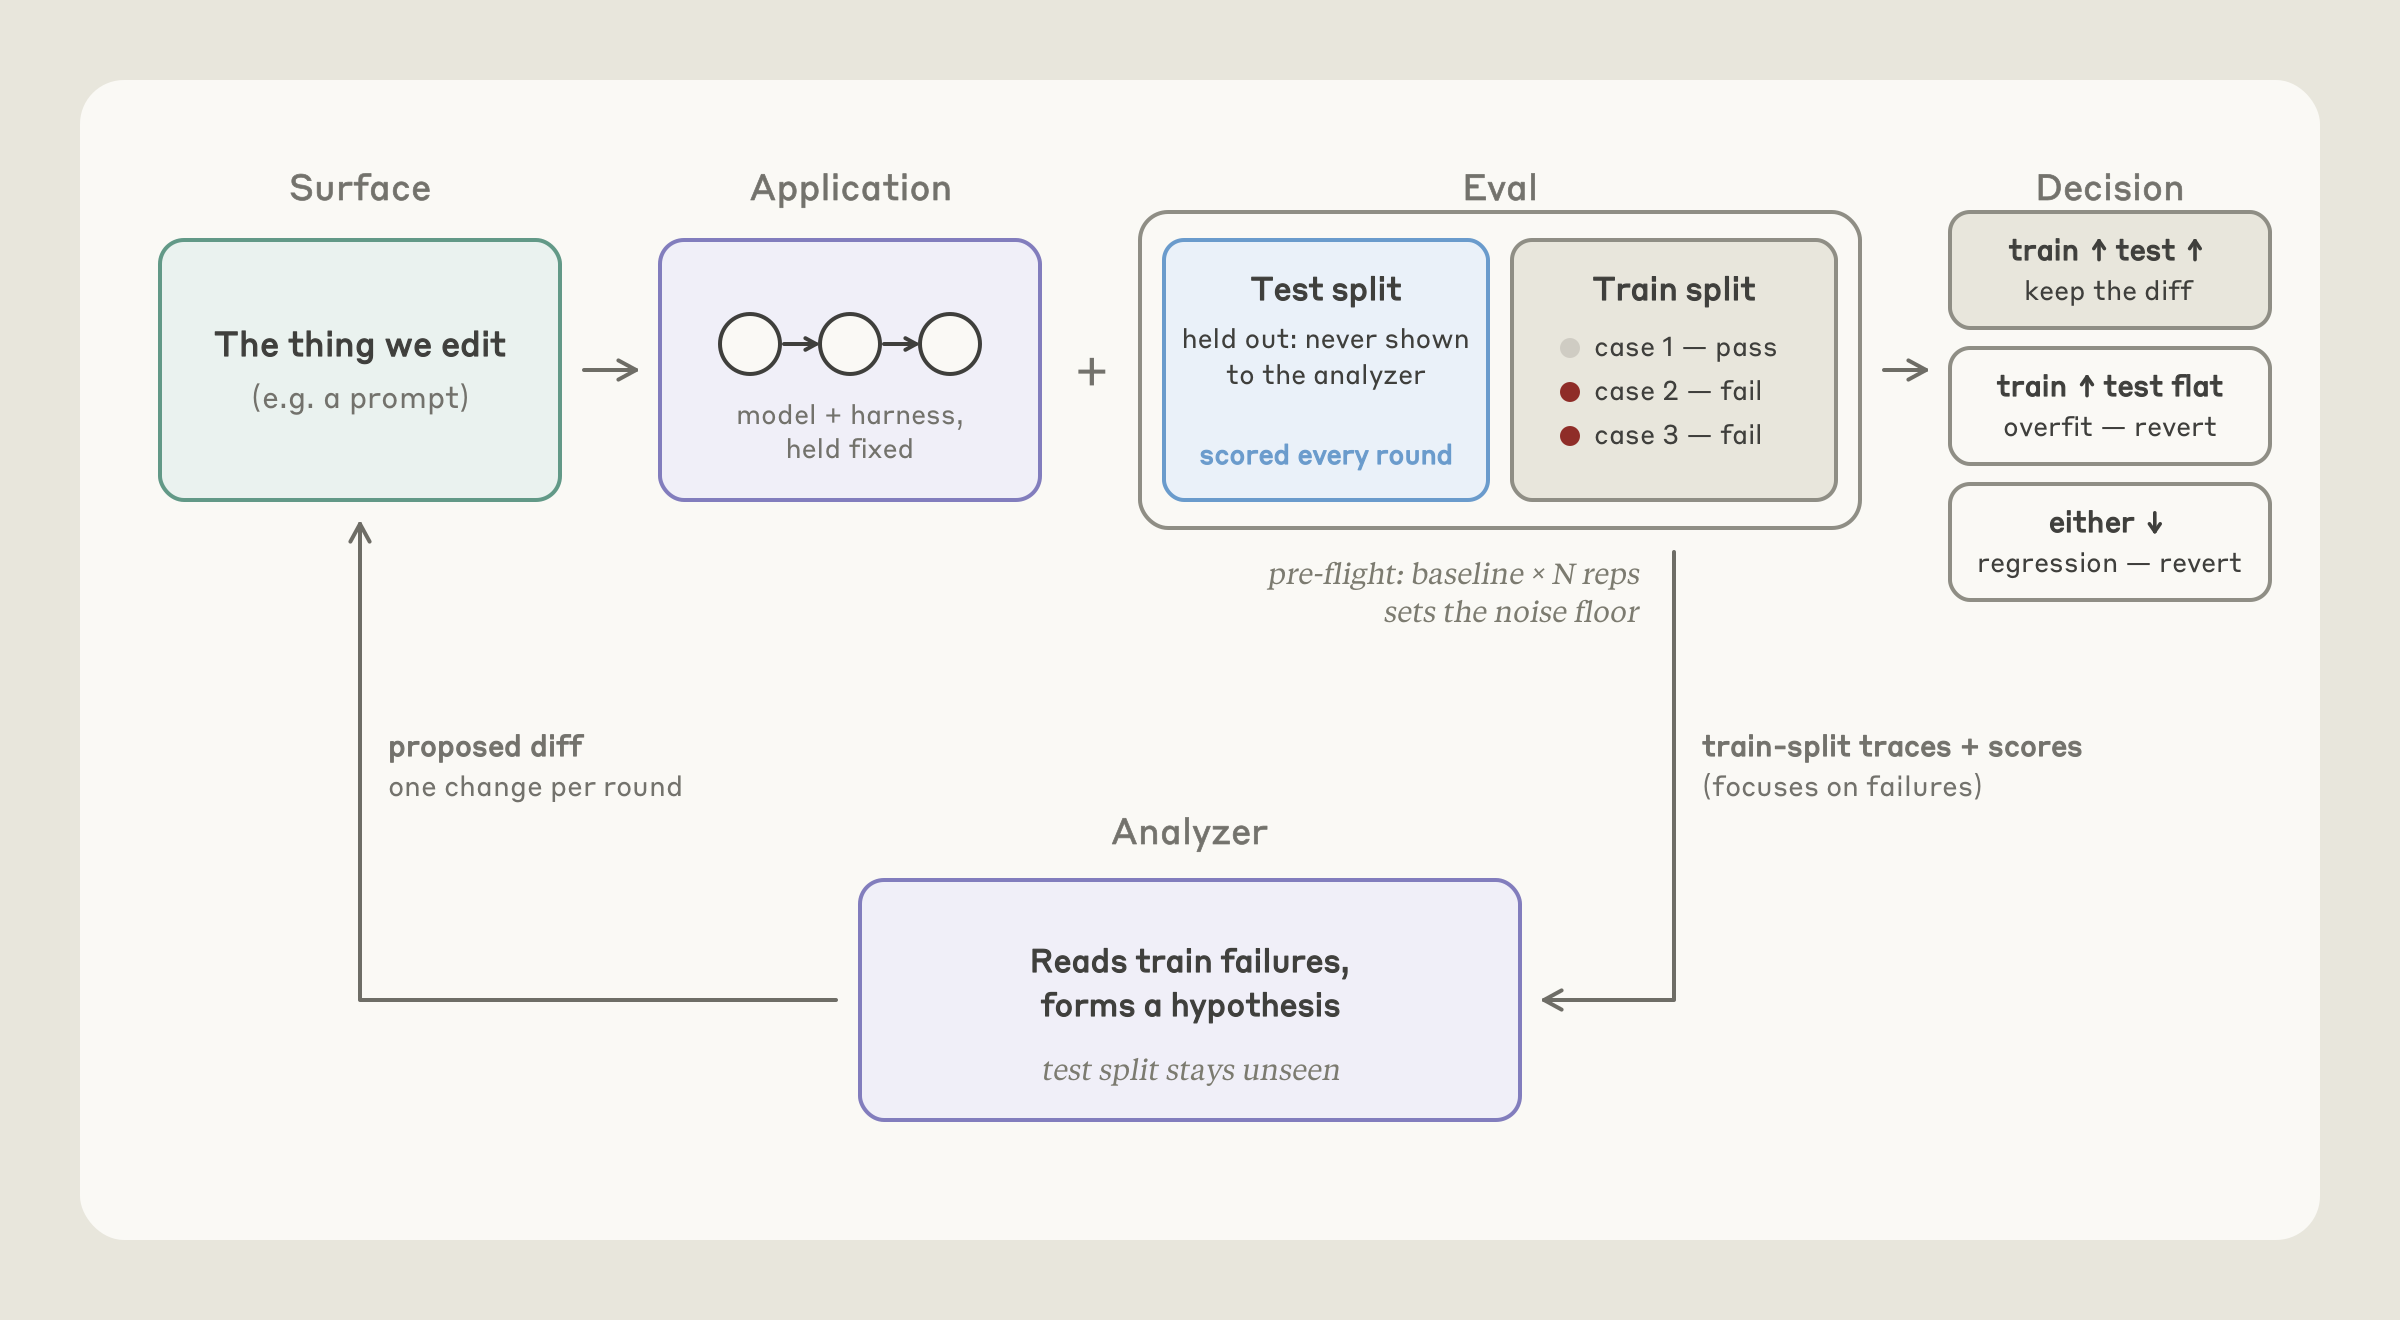
爬山迭代者使用的流程。
分数卡住两三轮时,Claude 读每个剩余 train 失败并按原因分类。若没有任何单次修复能超过评测噪声,也会提早做同样的事,并建议更多重复或用例,而不是把轮次花在测不出的小改上。这一步可抓住含糊评测用例、harness 错误或运行间方差。
只有正当失败才进入更多爬山迭代轮次。
爬山迭代完成时,Claude 把代码留在对你目标在 test 集上最好的版本。报告相对基线的 test 结果与置信区间(图 7)。若增益在噪声内,会说明并建议不要合并。
爬山迭代后生成的报告示意。
示例
以降本为目标的爬山迭代
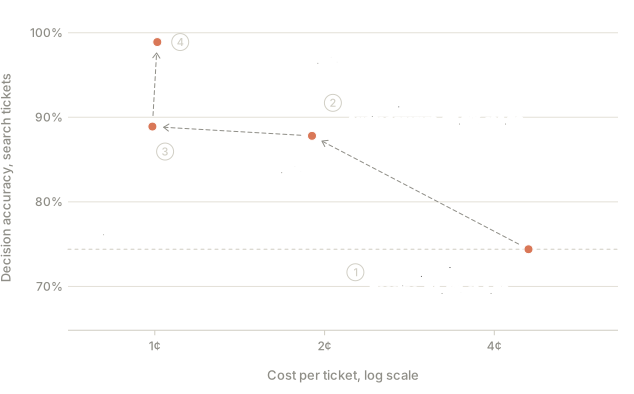
我们在一份 内部客服基准 上跑 /claude-api hillclimb,目标是降本并提表现。基准含 44 张 ticket,30 张用于搜索,14 张留出。起点是 Opus 4.8 默认(high)effort,搜索 ticket 上决策准确率 74.4%,每 ticket token 成本 4.6 美分。
爬山迭代先审计提示词,去掉 强制工具调用仪式、scratchpad 步骤与矛盾规则。然后试 Opus 5.5 的 low effort。决策准确率过基线门槛到 87.8%,成本降到每 ticket 1.9 美分,不到起点一半。
部分节省来自 Opus 5.5 的定价:输入与输出 token 比 Opus 4.8 便宜 20%,缓存读取便宜 60%。因 Opus 5.5 过了门槛,爬山迭代再降一档,看更便宜的模型能否也过。Sonnet 5 在 low effort 上大约相当,88.9%,成本约一半,每 ticket 约 1 美分(图 8)。
图:搜索 ticket 上决策准确率相对每 ticket 成本(对数坐标),追踪采纳路径:Opus 4.8 high effort 基线 74.4% / 4.6¢;审计提示词后的 Opus 5.5 low effort 87.8% / 1.9¢;同一提示词的 Sonnet 5 low effort 88.9% / 约 1¢;改进提示词后的 Sonnet 5 98.9% / 约 1¢。虚线标起点准确率 74.4%。
聚焦成本的爬山迭代。
最后 Claude 用路由规则与退款上限交叉引用改进提示词,把 Sonnet 5 带到 98.9%,成本大致相同。在搜索从未见过的 14 张留出 ticket 上,最终配置 90.5%,相对原配置 78.6%,成本约五分之一。
以提表现为目标的爬山迭代
另一例是我们的 claude-api Skill,提供 API 用法与使用 Claude 的一般技巧(含本文讨论的子命令)。我们要确保 Skill 能正确实现使用我们 API 的代码,并基于文档建了评测集来测它。
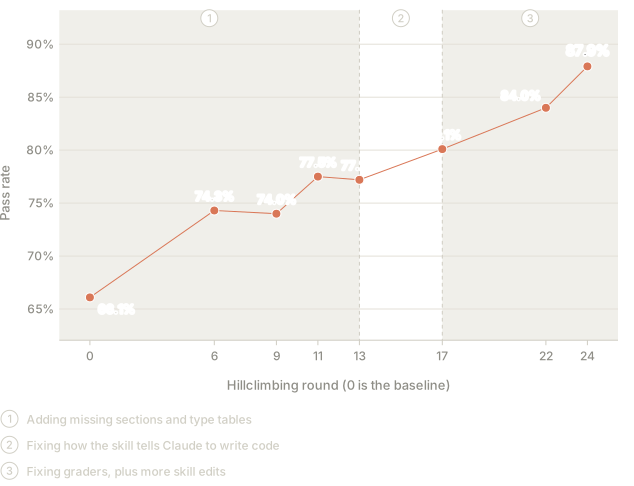
在评测上 Skill 起点 66%。我们给爬山迭代者访问文档与 SDK,让 Claude 找出错误并自我纠正(图 9)。Claude 发现 Skill 缺八个功能的覆盖。
为它们加小节后表现到 74%。再发现 C# 与 Java 类型表错误,抬到 77%。
图:claude-api Skill 评测上爬山迭代各轮通过率,从基线 66.1% 到第 24 轮 87.9%。三个编号阶段:补缺失小节与类型表;修 Skill 告诉 Claude 如何写代码的方式;修打分器加更多 Skill 编辑。
聚焦表现的爬山迭代。
分数卡住两轮后,Claude 分析剩余失败并按根因分桶。正常一轮为最常见失败做一处编辑。这一步不做编辑,只按原因给每个剩余失败分类。这个反思步骤在几方面有用:
- 跨一批失败反思后,爬山迭代者发现 Skill 内容在,但 Claude 只是在写更旧的 API 形状(例如来自训练先验)。于是在 Skill 顶部附近加表,把 Claude 记得的形式导到当前形式:例如从 API 在近期 Opus 上已拒绝的、带固定 token 预算的 extended thinking,到 adaptive thinking;从旧版 web search / web fetch 工具到当前版。并把 C# 与 Java 对固定预算 thinking 的警告移到其 adaptive-thinking 示例之上。表现升到 80%。
- 内容缺口已补却从未改善的任务,是用例或打分器有缺陷的信号。一题要求捕获一种错误类型的代码,打分器却要至少三条链。Claude 改写了任务。另一打分器说明与文档矛盾,测真实 API 证明文档对。处理这些再加更多 Skill 编辑后,表现到约 88%。
开始动手
注意: 先跑 claude update。claude-api Skill 随 Claude Code 发布,更新才能拿到这些命令的最新版。
claude update然后在 Claude Code 里:
/claude-api build-eval
/claude-api hillclimb
这些子命令可经 claude-api Skill 在 Claude Code 里直接用:
想为某问题生成评测集时跑 /claude-api build-eval。可提供用例访问(如 traces)来引导。Claude 会按本文指引设计用例与打分器,并确保你批准用例与打分器。
已有评测、想让 Claude 按你的目标(例如更好表现,或表现持平时更低成本)提升时跑 /claude-api hillclimb。Claude 会按本文指引在爬山时查过拟合,并在第一轮前以及分数卡住时检查评测本身的 bug,例如把看起来正确的答案判错的打分器,或 harness 错误。
特别感谢 Misha Khalman 的 Skill 开发。感谢 Misha Khalman、Michael Segner、Matt Bell、Matt Thanabalan 与 Punit Shah 的审阅、贡献与产品支持。
附录:原页面上的图
这些图在原页面上,但官网的 Markdown 导出里没有,所以附在文末;它们在原文中的位置和说明请看英文原文。