工程里常说 “cache rules everything around me”,对 Agent 同样成立。
像 Claude Code 这类需要长时间跑的 agentic 产品,能成立很大程度靠 提示词缓存:复用此前往返里已经算过的结果,显著压低延迟和成本。
在 Claude Code,整套 harness 都围着提示词缓存来建。命中率高,成本就低,订阅套餐的速率限制也能更宽松;所以我们对提示词缓存命中率设了告警,太低就开 SEV。
下面是规模化优化提示词缓存时学到的几条(往往反直觉)经验。
按缓存来排提示词
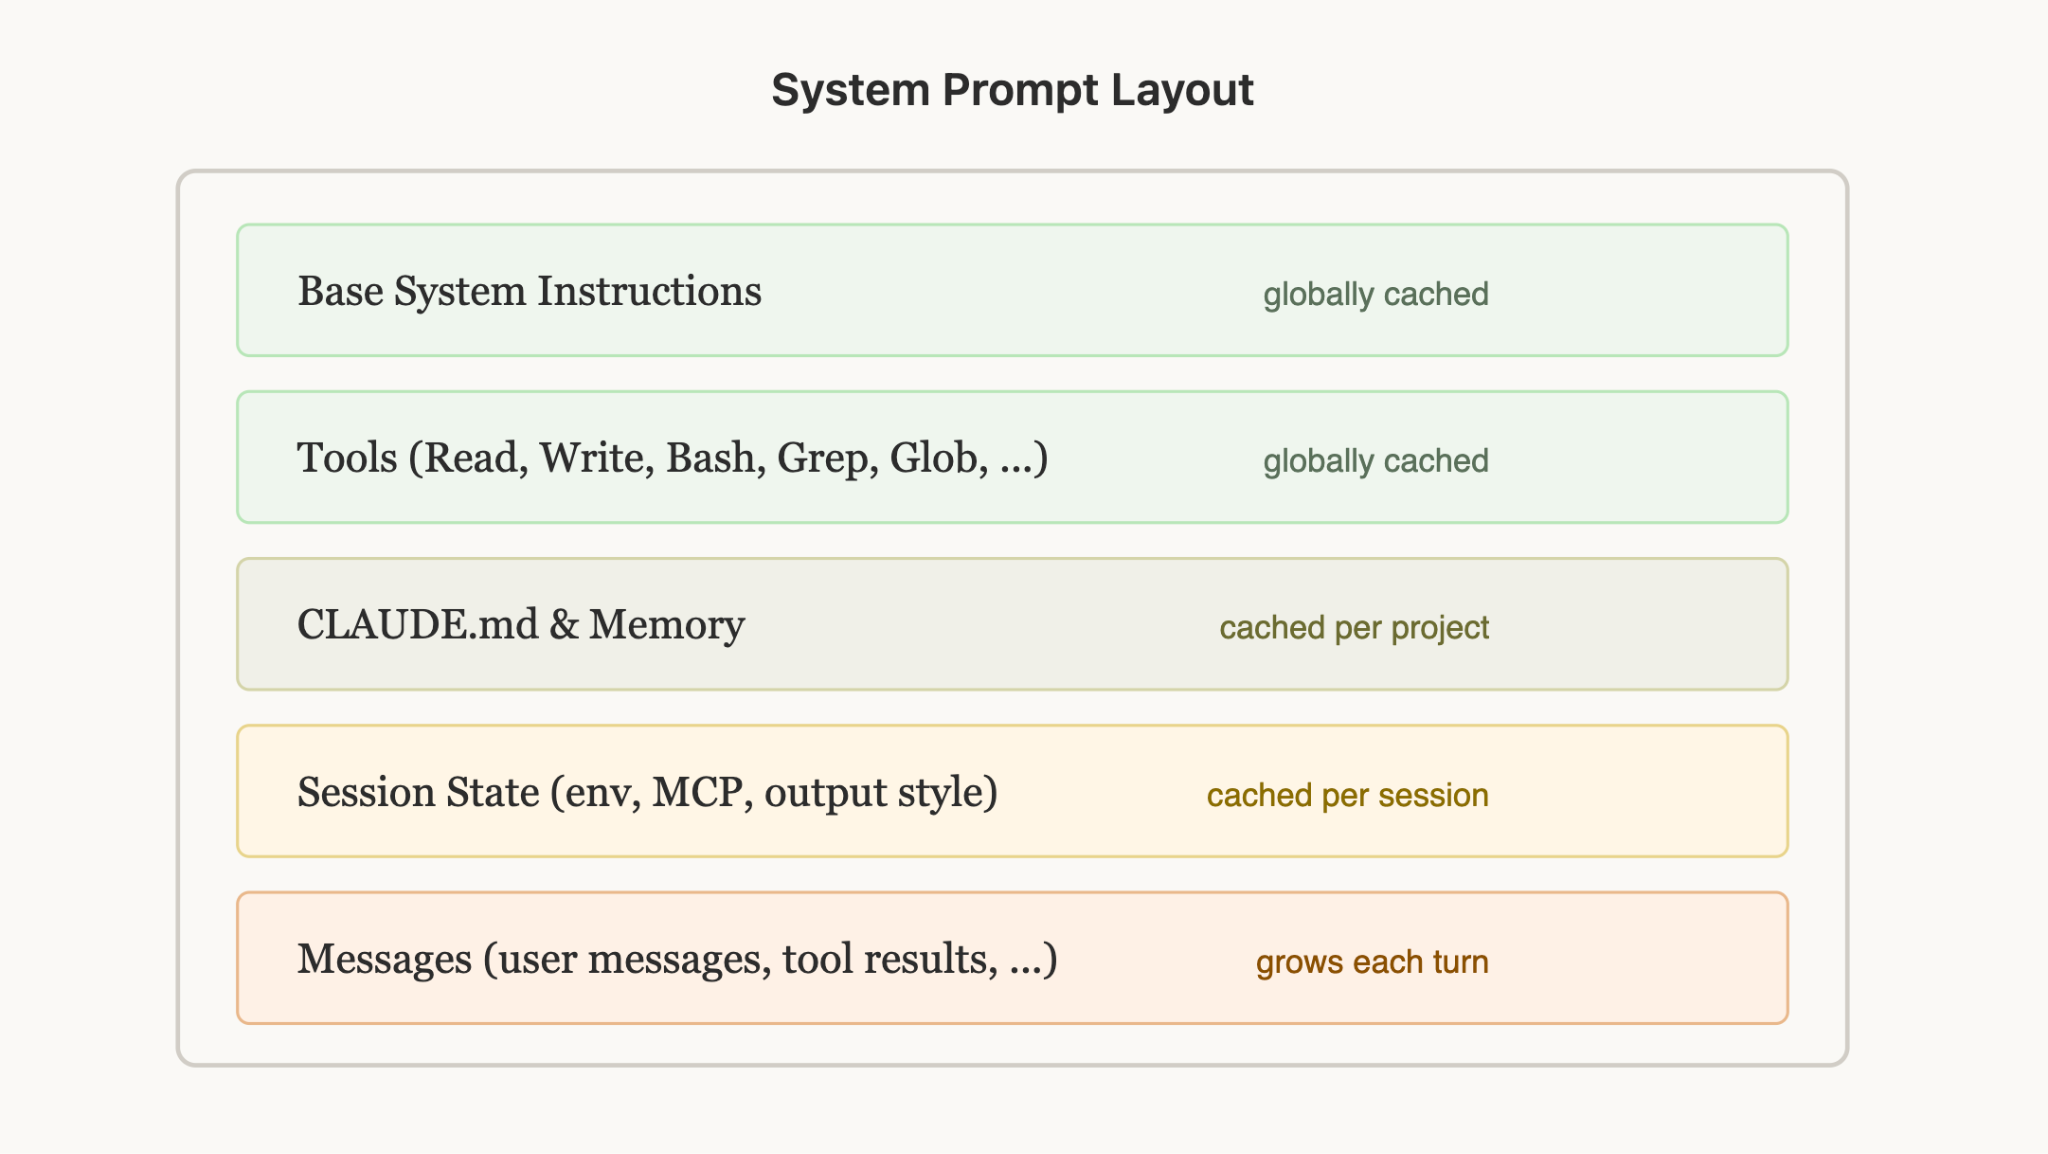
Claude Code 的系统提示词按「稳的部分尽量留在缓存里、只有对话本身随轮次变长」来组织。
提示词缓存靠前缀匹配——API 从请求开头一直缓存到每个 cache_control 断点。因此顺序极其重要:要让尽量多的请求共享同一段前缀。
提示词怎么排,也影响输出质量,不只是命中率——另一半功课是 提示词工程基础。
做法是:静态内容在前,动态内容在后。Claude Code 大致是:
- 静态系统提示词与工具(全局可缓存)
- CLAUDE.md(项目内可缓存)
- 会话上下文(会话内可缓存)
- 对话消息
这样能让尽可能多的会话打中同一段缓存。
但这套顺序其实很脆。我们以前就破坏过它,原因包括:在静态系统提示词里塞了精确到很细的时间戳、工具定义顺序非确定性地打乱、以及改了工具参数(例如 Agent 工具可以调用哪些 Agent)。
用消息传递更新,而不是改提示词
提示词里的信息会过期,比如当前时间,或用户改了某个文件。这时很想直接改提示词,但会 miss 缓存,对用户可能很贵。
先想想能不能在 Agent 下一轮的消息里带过去。Claude Code 会在下一条用户消息或工具结果里加 <system-reminder>,把更新告诉模型,从而保住缓存。
会话中途不要换模型
提示词缓存是按模型隔离的,账会算得很反直觉。
例如你已经和 Opus 聊了 10 万 token,忽然想问一个很简单的问题:切到 Haiku 往往比继续让 Opus 答更贵,因为要给 Haiku 重建整段提示词缓存。
必须换模型时,更好的做法是用 subagent:让 Opus 写一份「交接」消息,交给另一个模型去做那件事。Claude Code 的 Explore Agent 常用 Haiku,就是这种模式。
会话中途不要增删工具
对话中途改工具集,是搞砸提示词缓存最常见的方式之一。直觉上「现在用不到的工具就别给」很合理;但工具定义落在缓存前缀里,增删任一工具都会让整段对话的缓存失效。
用 Plan Mode 迁就缓存约束
Plan Mode 是「功能怎么围着缓存约束设计」的好例子。直觉做法是:一进 Plan Mode 就把工具集换成只读工具——但那会打穿缓存。
我们的做法是:请求里始终保留全部工具,把 EnterPlanMode / ExitPlanMode 自己也做成工具。用户打开 Plan Mode 时,Agent 收到一条系统消息,说明当前处于 Plan Mode 以及规则:先探索代码库、不要改文件、计划完成时调用 ExitPlanMode。工具定义始终不变。
额外好处:EnterPlanMode 是模型自己能调的工具,碰到难题它可以自主进入 Plan Mode,且不打断缓存。
用 tool search 推迟加载,而不是删掉
同一原则也用在 tool search 工具 上。Claude Code 可能挂着几十个 MCP 工具;每次请求都塞全量定义太贵,中途删掉又会打穿缓存。
办法是 defer_loading:不删工具,而是发轻量 stub(基本只有工具名,并标 defer_loading: true),模型需要时再经 tool search「发现」。完整 schema 只在选中时加载。同一批 stub 始终以同一顺序出现,缓存前缀就稳。
也可以通过 API 直接用 tool search 工具 简化这件事。
压缩时不要打穿缓存
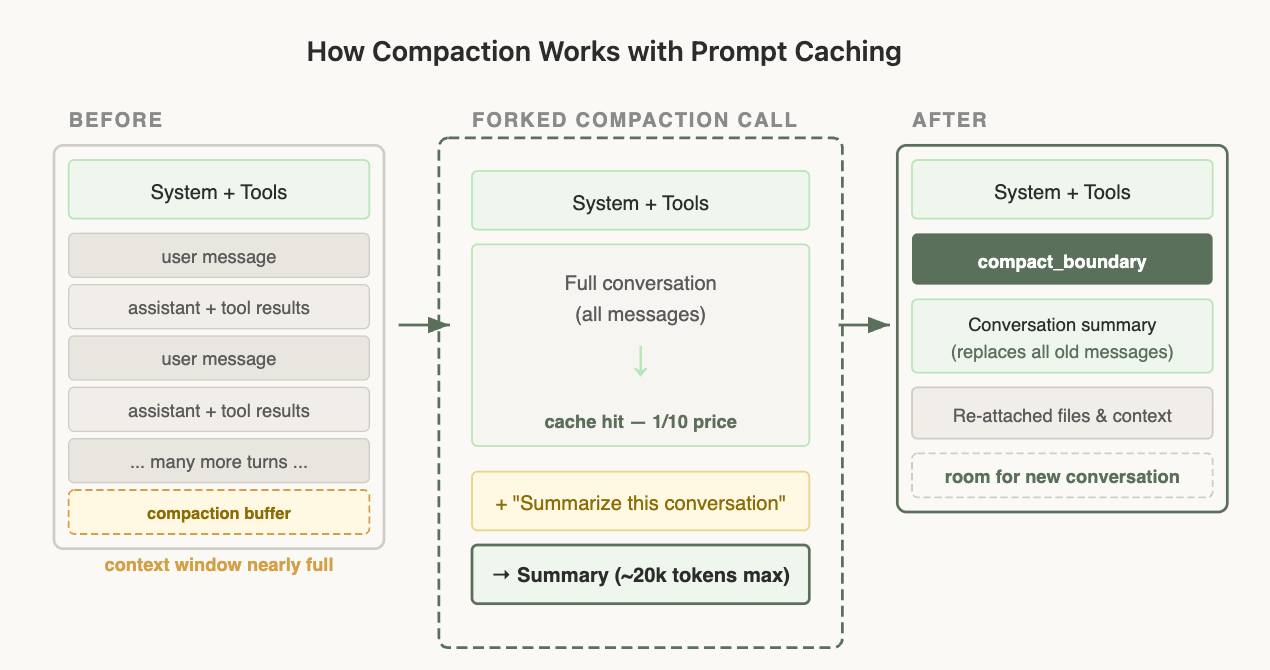
上下文窗口快满时,Claude Code 会 fork 一次已缓存的调用去总结对话,再用摘要替换原消息继续。
压缩(compaction) 发生在上下文窗口用尽时:先总结到目前为止的对话,再带着这份摘要开一段新会话继续。
压缩和提示词缓存的交互很容易做错。要压缩,就得把完整对话发给模型写摘要。最简单的做法是另开一次 API 调用,用另一套系统提示词(比如「请总结这段对话」)且不带工具——成本坑就在这里。提示词缓存只在请求前缀与已缓存内容从第一个字节起完全一致时生效。主对话缓存在某一套系统提示词和工具集下;摘要调用换了系统提示词又没工具,前缀从第一个 token 就分叉,缓存全部用不上。于是你要为整段对话按未缓存输入价付费——对话越长(越需要压缩),这一次调用越贵。
解法:对缓存安全的 fork
做压缩时,我们用与父对话完全相同的系统提示词、用户上下文、系统上下文和工具定义:先接上父对话的消息,再在末尾追加压缩提示词作为新的用户消息。
在 API 看来,这次请求几乎等于父对话的上一次请求——同一前缀、同一工具、同一历史——所以复用已缓存前缀。新增的只有压缩提示词本身。
代价是要预留一块「压缩缓冲」,好让上下文窗口里还能塞下压缩提示和摘要输出的 token。
压缩不好做,但你不必自己踩完这些坑——基于 Claude Code 的经验,我们把 compaction 直接做进了 API,你可以在自己的应用里套用同一模式。
学到的几条
搭 Agent、优化提示词缓存时,这些模式对我们很有用:
- 提示词缓存是前缀匹配。 前缀里任意一处改动,其后全部失效。整套系统都要围着这条约束设计。顺序对了,缓存多半会「免费」生效。
- 改状态用消息,别改系统提示词。 进 Plan Mode、换日期之类,很想改系统提示词;更划算的是在对话消息里插入这些信息。
- 对话中途不要改工具集或换模型。 用工具表达状态切换(如 Plan Mode),而不是换工具集。用推迟加载代替删除工具。
- 像盯可用性一样盯缓存命中率。 我们对缓存打穿设告警,当事故处理。几个百分点的 miss 就能大幅拉高成本和延迟。
- 旁路操作必须共享父对话的前缀。 压缩、摘要、跑 Skill 这类旁路计算,要用相同的、对缓存安全的参数,才能打中父对话的前缀。
Claude Code 从第一天起就围着提示词缓存来建;你要搭 Agent,也建议这么做。
开始使用 Claude Code。
本文作者 Thariq Shihipar,Claude Code 团队 Member of Technical Staff。