新一代 Claude 模型最好的一点,是它们能响应 effort,又不会在 Claude Code 里 打穿提示词缓存;但用户问得很多。effort 到底是什么、各档何时用?为什么需要 effort?
为回答这些,我对评测做了深挖,并在日常工作里自己测了不同 effort。
总体结论:effort 很适合用来调节 Claude 做多少验证与边界情况测试,以及用多少自己的判断。在硬件、代码审查、安全这类「验证与边界情况更值钱」的领域,多花 effort 效果更好。
对普通软件工程,我跑的是:先让模型采访我,再在 low effort 上实现,审一遍它做的,再在 high effort 上跑验证。
effort 是什么?
宏观上,effort 给模型一个近似:你希望它在这件事上花多少算力。它多少对应你对任务难度的建模。
可以这么想:若有人要你连续 12 小时做一件事,你大概会认定对方要你认真做完、尽力而为。若只要 1 小时,你会先交出能满足任务的最好一版,再指望后面迭代。
或者你会顶回去:这事至少要 3 小时,然后花 3 小时交付。
effort 也一样。Claude 总会尽量合理完成任务;更高的 effort 意味着 Claude 会更独立地做判断与验证。
effort 曲线
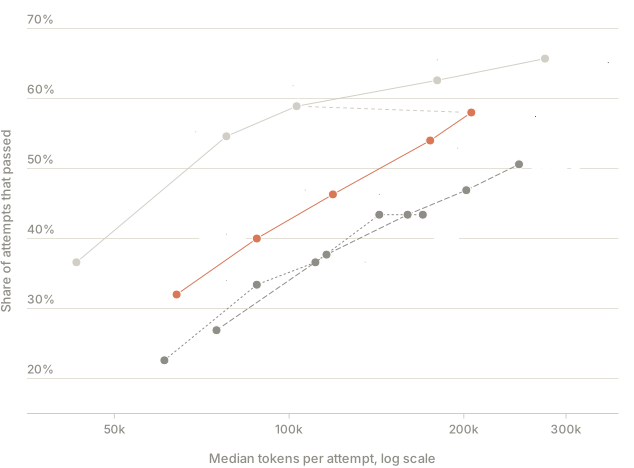
Fable 5.1 与 Opus 5.5 的 effort 曲线是目前最好的:每一档,基准分数与消耗的 token 都有抬升。
图:仅 Terminal-Bench 3.0——通过率相对每次尝试的中位 token 数(对数坐标),覆盖 Opus 5.5、Fable 5.1、Opus 5、Fable 5,每个 effort 设置(low 到 max)一个点。Opus 5.5 在每一档都最高,从 low 的 36.6% 到 max 的 65.7%;Fable 5.1 每一档都高于 Opus 5 与 Fable 5。Opus 5.5 的 high 与 Fable 5.1 的 max 相当(58.9% 对 58.0%),token 大约一半。Fable 5 从 xhigh 到 max 平台在 43.4%。
Terminal-Bench 3.0,每个模型同一批 70 个任务(去掉 4 个 GPU 任务)。Opus 5.5 大约晚三周跑,回复上限 128k token,无 GitHub / PyPI 访问;Opus 5 的 max 是其 effort-120 那次。
实践上意味着什么?我用不同 effort 档试了若干任务,并细读基准。
带着 effort 构建
理解模型最好的办法是做实验。我在 Opus 5.5 上用多种 effort 做同一批任务,看它会做多少活。工作面很广,下面用几个玩具例子说明。
欠规格的构建任务
若让 Claude「做个个人健身与训练追踪 App」,effort 会大幅改变 App 的丰满程度,也会让 Claude 沿途做更多选择。low effort 下,健身 App 只是日志加简单图;更高档会更复杂、细节更多;max 时还有热力图。
交互图:一句话提示下,Claude 在 low / medium / high / max effort 做出的健身 App,各自自演示。 见原文页:https://claude.dev/blog/spending-your-effort/
若只要一个可迭代的简单底座,low 就够。若要 Claude 一次给出最好的一枪,用 max。
轻度规格的设计任务
若任务已经大致定了规格,但仍想和 Claude 一起探索?例如让它重设计 Claude Code 的 /config 菜单。每一轮大致同一思路:子菜单 + 更好的搜索。
low effort(约 1 分钟)得到交互草图,能传达想法,但不太像 Claude Code。
max effort(约 28 分钟)得到很像 Claude Code 的 mockup,外加多条流程的 walkthrough。
若目标是迭代与给反馈,low 更快。max 则一上来更精致。对这个任务,我更倾向用 low 先摸清 Claude 的愿景。
交互图:Claude Code /config 菜单在 low / medium / high / max 下的重设计,一次一屏。 见原文页:https://claude.dev/blog/spending-your-effort/
高度规格的构建任务
若给 Claude 很多细节呢?我让 Claude 先深入采访我关于健身 App,再把规格交给不同模型、不同 effort 去实现。
有了这份规格后,模型行为接近得多:设计与实现大致相似,细节不同;max 时 Claude 会花时间简化其中几处。
交互图:按采访规格在 low / medium / high / max 做出的健身 App,手机形态,同一套演示驱动。 见原文页:https://claude.dev/blog/spending-your-effort/
小结
对常规软件工程、尤其新功能,effort 档位很大程度上取决于我想多大程度「在环」。low 让 Claude 快速给起点;更高档会做更多活,也会替我做更多假设。
功能开发里我一直觉得很有效的循环是:
- 给 Claude 一份规格,让它采访我缺了哪些细节
- 用 low effort 实现
- 审一遍是否抓住大意,需要时继续用 low 迭代
- 用 high effort 做验证与测试
困难任务上 effort 如何影响输出
上面明显是玩具题,Claude 都能完成。若差别是「完成 vs 完不成」呢?
要找难题就得看基准。我选了一个喜欢的:社区贡献的 Terminal-Bench 3.0。
Terminal-Bench 3.0 大体可分成安全、硬件、ML、科学、软件、运维、媒体等。全部题目见:https://github.com/harbor-framework/terminal-bench/releases/tag/v3.0.0。来自社区,谁都能贡献。
值得读一遍,感受模型面对的问题类型。很多任务的范围与野心让我吃惊,远比我日常任务复杂。
例如包括:
- 硬件(
retro-console-soc):用 Verilog 做一台能塞进小 FPGA、能渲染测试 ROM 的 8 位游戏机。 - 科学(
takens-embedding-lean):在 Lean 4 里形式化证明 Takens 嵌入定理。 - ML(
mp-checkpoint-consolidation):把 16 个 mixture-of-experts checkpoint 分片合成一个文件,并能复现参考 logits。 - 运维(
intrastat-meldung):端到端跑完一家公司月度欧盟贸易统计申报。 - 媒体(
layout-config-recreation):把海报图重建成可编辑的 layout 文件。
边界情况多时,更高 effort 更有用
读 Terminal-Bench 3.0 结果后的主结论是:隐藏边界情况很多的任务,更高 effort 最好。
干净例子是 html-js-filter:要一个 HTML sanitizer,剥掉所有把 JavaScript 塞进页面的路径。Fable 5.1 从 low 的 1/5 到 xhigh 的 5/5。¹
low 的典型尝试大约 2 分钟:大致一遍写出 filter,再用单页手写页面测一下。
high 大约 33 分钟。我追踪的那次:对抗式审查初稿,读已安装解析器源码查 bug,跑大量干净用例直到输出与输入一致,再跑标准 XSS 套件,最后写随机文档 fuzzer。
对 HTML sanitizer 这种边界密集的东西,多花 effort 值得。为彻底性多花 token 也适合性能优化或安全审查这类生产要求高的复杂任务。
但不是每件事都需要这一档。
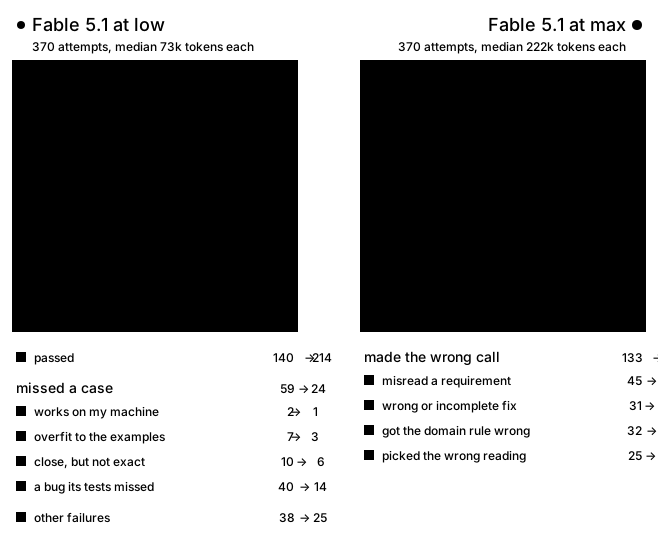
下图展示 Terminal-Bench 3.0 每一次结果及失败方式,跨模型与 effort。总体而言,提高 effort 往往减少因漏掉边界情况导致的失败(紫色块),但修不好模型路线本身就错的情况(蓝色块)。
交互图:Terminal-Bench 3.0 每次尝试按失败方式分类,按模型与 effort。 见原文页:https://claude.dev/blog/spending-your-effort/
effort 更有帮助的问题域
在 Terminal-Bench 3.0 上评这些模型时,一个有趣结论是:有些问题域从 effort 获益更多。见下图:
交互图:effort 在哪里划算——各任务类别在 low 与最高 effort 的通过率,按模型。 见原文页:https://claude.dev/blog/spending-your-effort/
为说明,我从不同领域挑了几道:Opus 5.5 在 low 失败、在 high 成功——多半因为测到并处理了边界情况:
mvcc-lsm-compaction:按崩溃报告修存储引擎 bug,且不能破坏 compaction。Opus 5.5 从 low 的 0/5 到 xhigh 的 4/5。
low(每次约一分钟):Claude 往往还没构建或跑复现就改代码,也不检查新测试是否本该抓住原 bug。
xhigh(约 11 分钟):先复现崩溃,相对一个从不 compact 的参考实现写随机化测试,并检查半成品修复是否会让测试失败。
cli-2ph-simplex:用 Python 写 CLI 线性规划求解器。Opus 5.5 从 low 的 0/5 到 high 的 5/5。
low:一遍写出求解器,用几个小问题检查,停在大约 10k token。最后消息里 Claude 警告大题可能慢,但没真测。
high:用独立暴力求解器在随机问题上测,再给更大题计时,撞上过久或崩溃的情况,然后改搜索。
gsea-proteomics:对蛋白质组数据做基因集富集分析(GSEA),看八种处理里哪些像目标组织。Opus 5.5 从 low 的 0/5 到 high 的 4/5。
low:选一种听起来合理的数据预处理,只按那种跑完并报告。
high:试两种预处理,发现显著处理列表会变,先挖原因再选正确的那条。
若用户在环,Claude 可能会问怎么设问题;无人在环时,high effort 更好。
Claude Code 里各 effort 档何时用
我的经验法则:
- Low:要快速、在环的回应时,例如头脑风暴、草图、简单改动
- Medium:大部分日常软件工程,例如新功能实现
- High:验证重要或边界情况多时,例如在存量代码库修 bug
- Max:要 Claude 完全自主解决难题时,例如端到端构建并验证一个 App、在关键软件里找安全漏洞
按任务(甚至对话中途)用 Claude Code 的 /effort 切换 Opus 5.5 与 Fable 5.1 的 effort,看是否符合你的直觉。
¹ 关于数字:来自我们内部跑法,每题 5 次;Fable 5.1 关掉了生产安全干预。在 Claude 产品里,Fable 5.1 的安全护栏会把部分安全请求交给 Opus。安全类任务也无外网,因此这里的每题计数不会与公开排行榜或发布帖对齐。工作示例来自单次运行,有些是中间 effort 档。
附录:原页面上的图
这些图在原页面上,但官网的 Markdown 导出里没有,所以附在文末;它们在原文中的位置和说明请看英文原文。